Computing and AI
Introduction to Artificial Intelligence
Bilingual · 75 pp. PDF
引言
人工智能研究如何让系统感知环境、表示知识,并通过推理、规划和学习做出有效决策。一个任务需要什么样的智能体,取决于它能够获得哪些信息、采取哪些行动,以及如何评价行动的结果。
从确定性环境中的路径搜索,到包含约束、对手和随机性的决策问题,建模方式决定了算法可以利用的结构。搜索算法比较候选路径,约束满足算法推导合法赋值,博弈树分析对手的选择,马尔可夫决策过程则用状态、转移概率和奖励描述长期决策。概率与贝叶斯网络为不确定信息提供推断工具,机器学习进一步让模型从数据和经验中获得规律。
理解这些方法,既需要掌握算法步骤,也需要把握其适用条件:状态表示是否充分、启发式是否可采纳、变量是否条件独立、训练与评估数据是否合理划分。清晰的模型假设、准确的数学定义与具体例题,共同构成分析人工智能问题的基础。
符号约定
搜索中的 \(g(n)\) 表示已走路径代价,\(h(n)\) 表示剩余代价的估计,\(h^*(n)\) 表示最优剩余代价;MDP 中的 \(V^\pi\)、\(V^*\) 分别表示给定策略和最优策略的期望回报。机器学习中,样本特征写作列向量 \(\mathbf{x}\),权重为 \(\mathbf{w}\),偏置为 \(b\)(也常记为 \(w_0\))。不同章节的同名字母应结合上下文理解。
Lecture 1: Agents
1.1 智能体与环境(Agents and Environment)
智能体(agent)通过传感器感知环境,通过执行器对环境采取行动。
| 概念 | 含义 | 示例 |
|---|---|---|
| 环境(environment) | 智能体所处并与之交互的外部世界 | 道路、房间、棋局 |
| 传感器(sensor) | 接收环境信息并转化为程序可使用的输入 | 摄像头、温度传感器、棋盘状态接口 |
| 执行器(actuator) | 把决策转化为影响环境的输出 | 车轮、电机、软件操作接口 |
| 感知(percept) | 某一时刻接收的感知输入 | 当前图像、当前温度 |
| 感知序列(percept sequence) | 截至当前的完整感知历史 | \(p_1,p_2,\ldots,p_t\) |
智能体函数(agent function)描述每一种可能的感知序列应对应什么行动:
\[ f:\mathcal{P}^*\rightarrow\mathcal{A}. \]
其中 \(\mathcal{P}^*\) 是有限感知序列的集合,\(\mathcal{A}\) 是行动集合。上式是确定性智能体函数;随机化智能体可将感知历史映射为行动的概率分布。
智能体程序(agent program)是在计算架构上实现这种行为的具体程序。它每次可以只接收当前感知,但利用内部状态保存历史信息的摘要,因此并不等于“只能依据当前感知决策”。
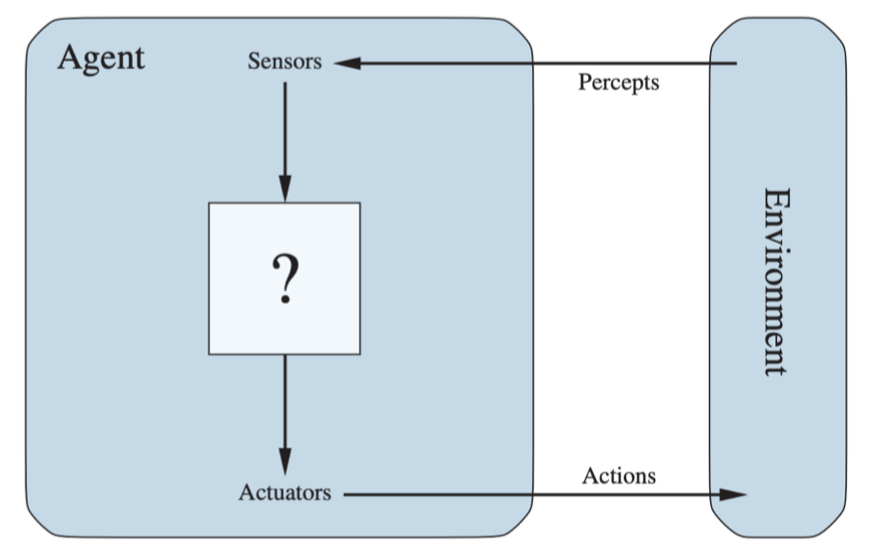
示例:微波炉与国际象棋 AI
微波炉(Microwave Oven)的感知、执行与环境可以分别列出:
- Sensors:温度传感器检测食物温度;湿度传感器辅助判断加热进度;门开关传感器检测炉门是否关闭;触摸屏或按钮接收用户选择的时间和模式。温度与湿度检测功能取决于具体机型。
- Actuators:微波发生器加热食物;转盘电机转动托盘,使加热更均匀;显示屏输出时间和模式;蜂鸣器在完成或发生异常时发出提示。
- Environment:食物与炉腔、周围厨房、供电条件以及用户交互。例如开门、停电和用户改变设置都会影响运行。
国际象棋 AI(Chess AI)也可分别分析:
- Sensors:读取棋子位置、当前走子方和其他规则相关状态。
- Actuators:通过软件接口提交走子,或驱动实体棋盘上的机械装置。
- Environment:棋盘、棋局规则和对手。人类和 AI 都是会选择行动的对手。
- 国际象棋 AI:输入接口读取棋局,输出接口提交合法走子。“计算最佳走法”属于内部计算,执行走子才是对环境的行动。无论对手是人还是另一个 AI,通常都建模为多智能体环境。标准国际象棋是完全可观测的;完整局面还应包括轮到谁走、王车易位权、吃过路兵信息,以及与规则相关的历史记录。
1.2 理性(Rationality)与性能度量
理性智能体依据已有证据和知识,选择预期性能最好的行动。判断理性需要四类信息:
- 性能度量(performance measure):成功的标准是什么。
- 先验知识(prior knowledge):智能体事先了解哪些环境规律。
- 可执行行动:智能体能做什么。
- 截至当前的感知序列:已经获得哪些证据。
理性评价依据决策时可用的信息,而不是事后是否碰巧成功。性能度量可以评价整个环境状态序列,也可以计入时间、能耗、安全和行动成本,不能一概简化为“只看最终状态”。例如,两个吸尘机器人最后都把房间打扫干净,但耗时、耗电和碰撞次数不同,性能可能不同。
理性不等于全知
- 理性(rationality):根据当前证据,最大化期望性能。
- 全知(omniscience):预先知道每个行动的实际结果;现实任务中通常无法做到。
- 事后最优表现:根据实际发生的结果衡量表现;它与事前合理决策不同。
随机行动也可能是理性的,例如随机化可以帮助智能体摆脱确定性循环。理性并不要求总能成功,也不要求行动规则必须是确定性的。
信息收集与自主性(Autonomy)
信息收集本身可以是一种行动,例如机器人移动到更好的观测位置。是否值得收集信息,应比较预期收益与时间、能量等成本,而不是无限制地收集信息。
自主性指行为在多大程度上依靠自身经验学习,而非完全依赖设计者预先写入的知识。它不意味着拒绝外部感知、指令或反馈。更好的灰尘与障碍物传感器可以帮助吸尘机器人决策,但硬件增强是否合算仍由性能度量决定。
示例:让吸尘机器人更理性
- 明确性能标准:例如清洁覆盖率、剩余灰尘、耗时、能耗与碰撞次数。吸尘、拖地或随机移动都是手段,是否合适应由完整任务效果评价。
- 改进感知:灰尘传感器可以区分灰尘浓度,帮助优先处理更脏的区域;障碍物传感器识别家具与墙壁,减少碰撞;电量监测帮助判断何时返回充电。
- 改进行动选择:使用路径规划减少重复移动,按灰尘浓度调整吸力,并从环境扫描和清洁历史中学习。
- 比较收益与成本:更强传感器和更复杂计算也有成本,应判断它们是否提高预期性能。
对每一种可能的感知序列,理性智能体应根据该序列提供的证据和已有知识,选择使性能度量的期望值最大的行动。这里最大化的是事前的期望表现,不是预先知道实际结果后的事后表现。
1.3 PEAS 与任务环境
PEAS 用于描述任务环境(task environment):
| 缩写 | 含义 | 自动驾驶示例 |
|---|---|---|
| P | Performance measure,性能度量 | 安全、守法、时间、舒适度、能耗 |
| E | Environment,环境 | 道路、天气、车辆、行人、乘客 |
| A | Actuators,执行器 | 转向、制动、油门、信号灯 |
| S | Sensors,传感器 | 摄像头、雷达、定位与速度传感器 |
多项性能指标可能冲突,需要明确权衡;有些要求也可作为必须满足的硬约束。城市与乡村驾驶面临不同环境,传感器和执行器的设计应服务于任务。电池容量、悬挂结构和规划算法属于不同层面的系统设计因素,不宜全部归为传感器或执行器。
环境变化如何影响系统设计
- 城市驾驶、郊区驾驶与乡村驾驶的交通密度、道路结构和障碍物不同。城市可能更需要精细识别行人、信号灯和拥挤路口;崎岖乡村道路可能要求更合适的悬挂与车辆控制。
- 大面积房屋中的吸尘机器人可能需要更大电池与更有效的路径规划;小型公寓中,简单导航有时已经能达到任务要求。是否采用随机移动,应结合房间结构与性能标准判断。
- 自动驾驶的性能可以同时涉及到达目的地、燃油消耗、行程时间、运营成本、安全、乘客舒适度与利润。守法与安全既可以进入性能评价,也可以被设置为必须满足的约束。
任务环境(task environment)是智能体执行任务所面对的完整条件。设计智能体前,应尽可能明确 PEAS 四部分,避免只描述目标而遗漏输入、行动能力或实际环境。
1.4 任务环境的七个维度
这些维度相互独立,应分别判断。
1. 完全可观测与部分可观测
- 完全可观测(fully observable):感知足以确定决策所需的相关环境状态。不必为了弥补状态缺失而保存历史,但仍可能需要复杂计算才能选择最优行动。
- 部分可观测(partially observable):感知不足以确定相关状态,可以用记忆、内部状态或信念状态(belief state)推断隐藏信息。
- 不可观测(unobservable):没有可用的环境观测。仍可根据先验知识和行动历史制定理性策略,只是缺少观测反馈。
2. 单智能体与多智能体
- 单智能体(single-agent):任务中不需要把其他实体视为具有自身决策目标的参与者,例如简化的填字游戏。
- 多智能体(multi-agent):其他参与者的决策影响结果,可以合作或竞争,例如棋类、交通系统。
不是简单地数场景中有多少个物体;普通障碍物通常不视为智能体。
3. 确定性、非确定性与随机性
- 确定性(deterministic):给定完整当前状态与相关行动,后继状态唯一确定。
- 非确定性(nondeterministic):同一状态和行动可能产生多个结果,模型未必提供概率。
- 随机性(stochastic):使用概率分布描述这些结果。
确定性不等于“智能体知道状态”或“能轻易找到最优动作”。国际象棋的走子规则是确定的,但对手会选择什么仍属于策略不确定性。
4. 阶段性与顺序性
- 阶段性(episodic):任务分成相互独立的片段,当前片段的行动不影响后续片段的决策问题,例如理想化的独立图像分类。
- 顺序性(sequential):当前行动影响未来状态、收益或可用选择,例如棋类、路径规划。
5. 静态、动态与半动态
- 静态(static):智能体思考期间,环境不会自行变化,例如不计时的填字游戏。
- 动态(dynamic):即使智能体暂不行动,环境也可能变化,例如道路交通。
- 半动态(semidynamic):环境本身在思考期间不变,但性能评价随时间变化,典型例子是带棋钟的象棋。
“静态”并非行动永远不能改变环境;关注的是思考期间是否有外部变化。
6. 离散与连续
状态、时间、感知和行动可以分别是离散或连续的。例如象棋主要使用离散状态和动作;自动驾驶含有连续位置、速度与转向,也可以包含“换道”等离散决策。一个系统可以混合两种表示。
7. 已知与未知
- 已知(known):智能体了解行动结果的规律;随机环境中可以是已知转移概率。
- 未知(unknown):行动结果或观测规律需要学习。
已知不等于完全可观测:扑克规则已知,但对手手牌隐藏。未知也不等于不可观测:可以观测设备当前状态,却尚不知道不同操作如何改变它。“地图未知”是否构成未知环境,要看地图信息被视为隐藏状态还是尚未学会的模型。
各维度的具体任务示例
- 观测性:自动驾驶可能因雨雾、遮挡而看不到其他车辆,需要依据记忆和模型估计;完全可观测的棋局也仍可能很难计算最优动作。
- 智能体数量:简化为没有其他决策者的普通吸尘任务可视为单智能体;道路上的车辆和行人各有自身目标,属于多智能体任务。
- 不确定性:自动驾驶模型可用概率描述天气、轮胎打滑等造成的不同转移结果;标准棋类的走子结果确定,但对手选择另一个动作属于策略层面的不确定性。
- 阶段性与顺序性:理想化垃圾分类任务中,若每件物品的分类不影响下一件物品,可按独立片段处理;若机械臂位置、料箱容量或误分类会影响后续处理,则应使用顺序模型。象棋的当前走子会改变后续局面,属于顺序任务。
- 半动态性:考试题目可在答题期间保持不变,但若评分包含用时或超时惩罚,性能会随时间变化;并非所有考试都按用时连续扣分。
- 连续性:车辆位置、速度、转向角、加速与制动通常包含连续变量;象棋走子和棋盘位置主要是离散的。
- 已知与未知:无人机可能需要学习未知地形或运动规律;游戏玩家可能看见屏幕上的状态,却仍在学习游戏机制。规则已知的纸牌游戏仍可能隐藏对手手牌。
1.5 智能体程序与架构
\[ \text{Agent}=\text{Architecture}+\text{Program}. \]
架构是程序运行并连接输入输出的计算平台,可以是机器人硬件,也可以是软件智能体的运行环境。
| 比较项 | Agent function | Agent program |
|---|---|---|
| 性质 | 抽象的输入输出映射 | 具体算法与实现 |
| 输入视角 | 完整感知序列 | 每次接收当前感知,可维护内部状态 |
| 资源约束 | 数学定义本身不规定计算资源 | 受时间、内存和平台限制 |
理论上的映射不一定都能被有限资源的程序精确实现;实际设计通常需要考虑计算可行性。
1.6 智能体类型
| 类型 | 决策依据 | 关键特点 |
|---|---|---|
| 简单反射型 | 当前感知与条件—动作规则 | 不保留感知历史 |
| 基于模型的反射型 | 内部状态、环境模型与规则 | 可利用历史推断当前隐藏状态 |
| 基于目标型 | 当前状态、模型与目标 | 比较行动是否通向目标 |
| 基于效用型 | 不同结果的效用及其概率 | 处理结果优劣、风险与目标权衡 |
| 学习型 | 经验与反馈 | 改进上述结构中的模型、规则或策略 |
学习能力可以加入前四类结构,不是与它们互斥的第五种决策逻辑。
各类结构的例子包括:按接近信号开关的自动门;记录近期温度变化并依据模型响应的温控器;用 A* 规划路线的导航智能体;同时权衡时间、油耗与安全的自动驾驶智能体;通过训练数据与交互经验改进策略的学习系统,例如 AlphaGo。简单反射规则只响应当前输入,例如光敏机器人根据当前光照转向,而不记录过去的光照条件。
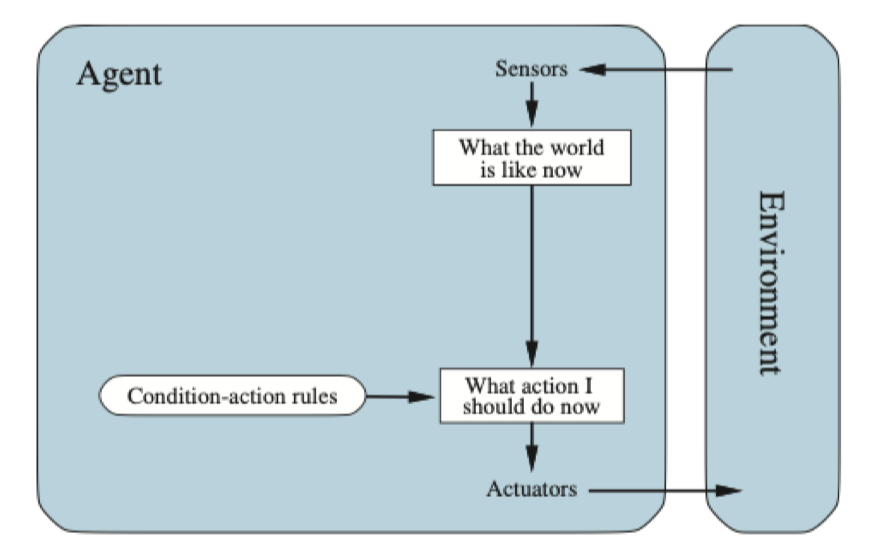
简单反射型(Simple Reflex Agents)
按照“如果条件成立,则执行行动”的规则直接响应当前感知。若同一感知下始终应选相同行动,它可以有效工作;完全可观测是常见适用条件,但并非必要条件。有些部分可观测任务也能由简单规则解决。
SIMPLE-REFLEX-AGENT(percept):
    state ← INTERPRET-INPUT(percept)
    rule ← RULE-MATCH(state, rules)
    return rule.action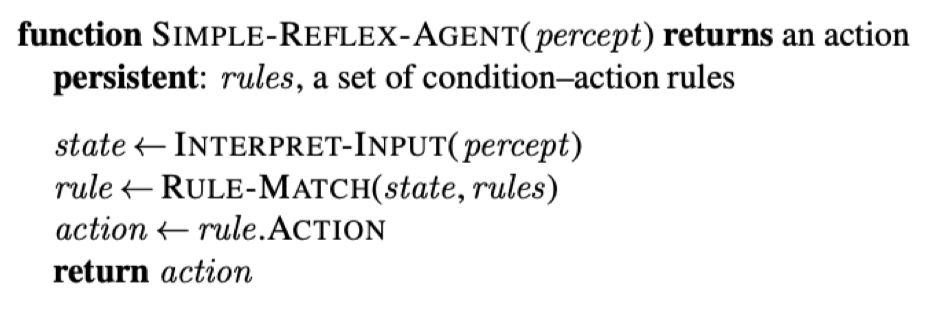
确定性规则对相同感知给出相同行动;随机化规则可以对行动进行采样,但不能凭空恢复缺失的环境信息。
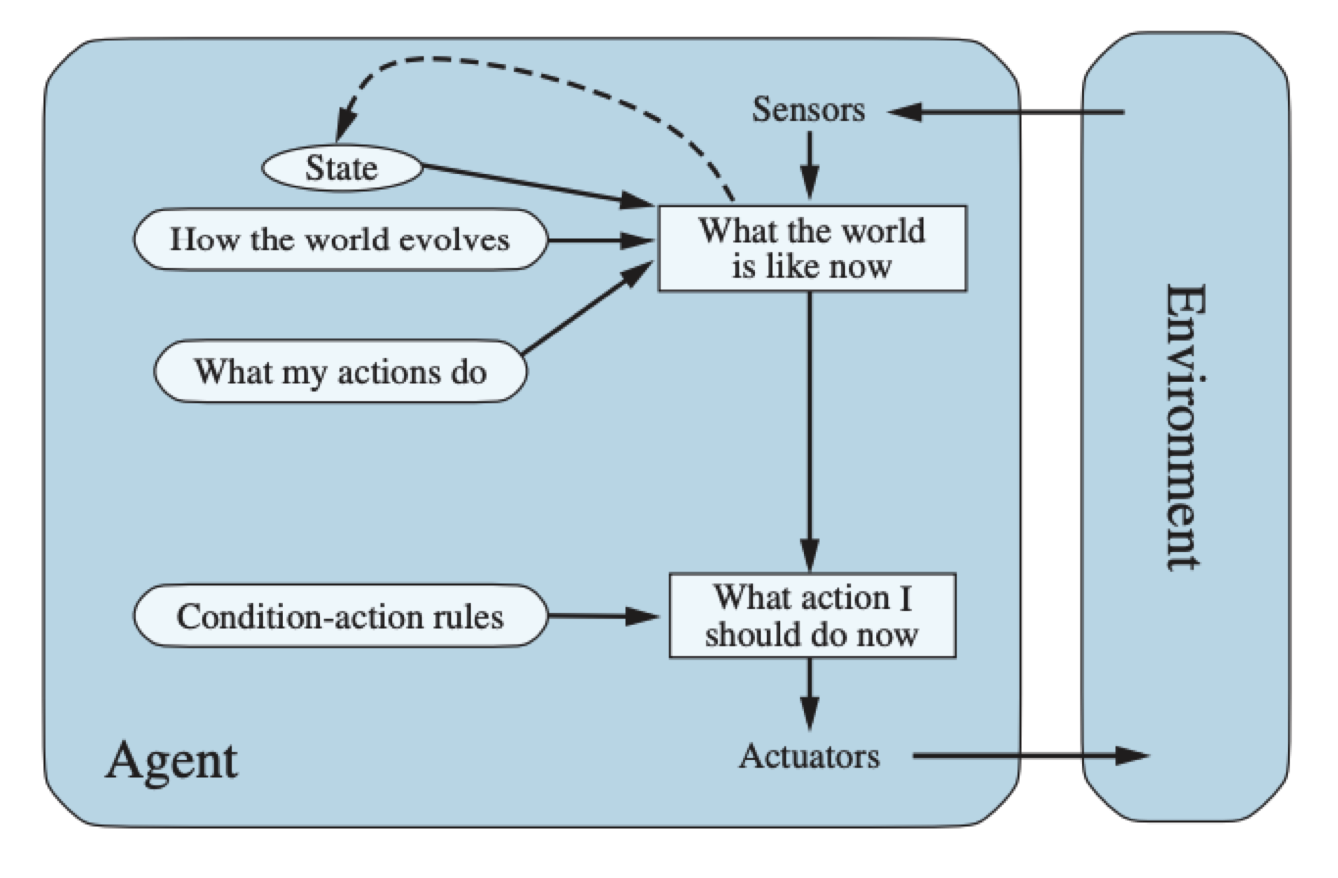
基于模型的反射型(Model-Based Reflex Agents)
维护对当前世界的内部估计,而不必存储完整原始感知历史。更新通常需要:
- 转移模型(transition model):行动和环境自身变化如何影响状态。
- 传感器模型(sensor model):真实状态与可接收感知之间有什么关系。
MODEL-BASED-REFLEX-AGENT(percept):
    state ← UPDATE-STATE(state, previous_action, percept,
                         transition_model, sensor_model)
    rule ← RULE-MATCH(state, rules)
    previous_action ← rule.action
    return previous_action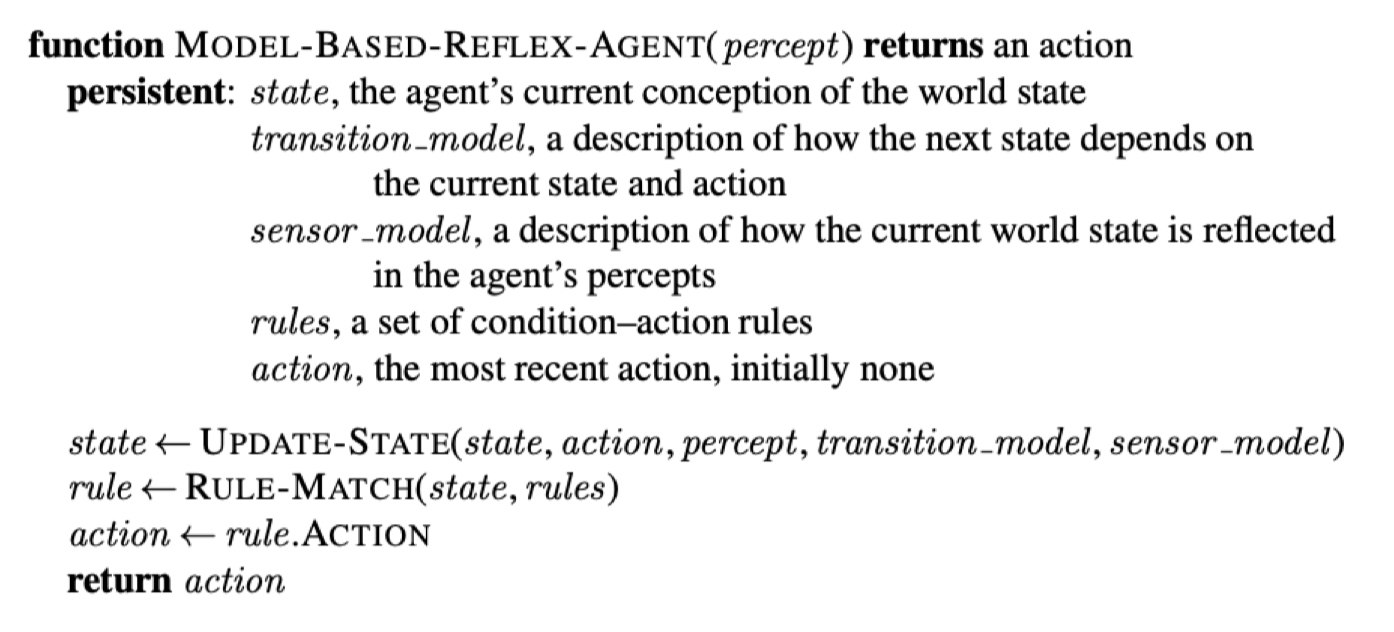
state、rules、模型和 action 不随一次函数返回而消失。这一过程逐步执行:先根据上次状态、上次行动与新感知更新状态估计,再匹配条件—动作规则,最后保存并返回此次行动。内部状态应反映当前看不见的相关信息,而不是被要求完整复制全部感知历史。
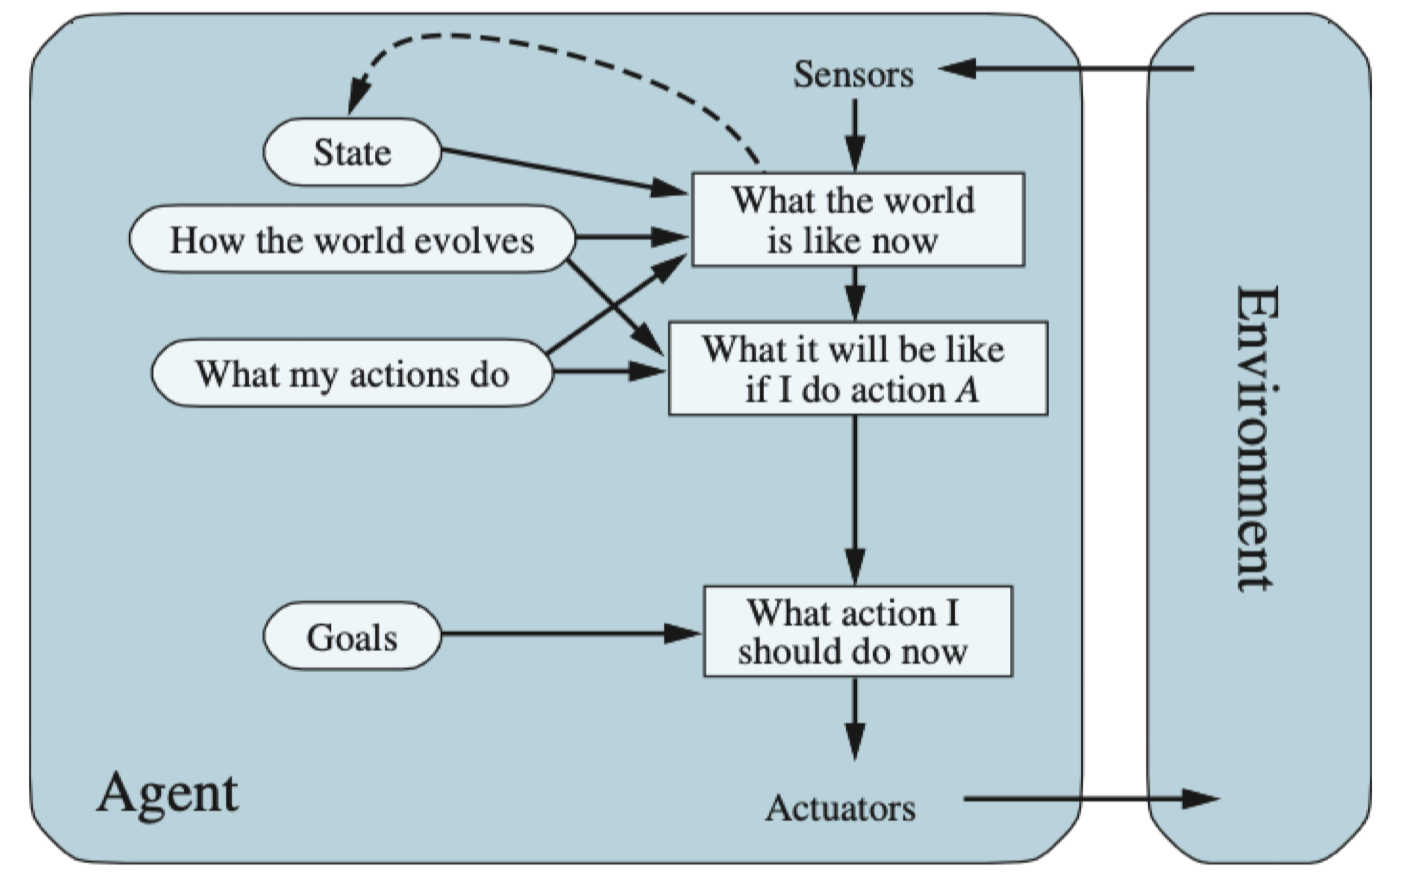
基于目标型(Goal-Based Agents)
只知道世界现在是什么样,并不足以决定应该做什么,还需要目标信息。目标型智能体用搜索或规划比较行动的未来后果,例如用 A* 寻找到目的地的路径。显式目标使决策更易调整,但搜索会带来计算开销。
基于效用型(Utility-Based Agents)
目标测试通常只区分“达成/未达成”;效用函数 \(U\) 进一步区分不同结果的优劣。在不确定性下,可以选择期望效用最大的行动:
\[ a^*\in\arg\max_a\sum_{s'}P(s'\mid a,\text{evidence})U(s'). \]
效用函数应与外部性能目标一致,才能让内部优化服务于任务。效用型结构本身不保证具有学习能力,也不保证计算出的行动一定最优。
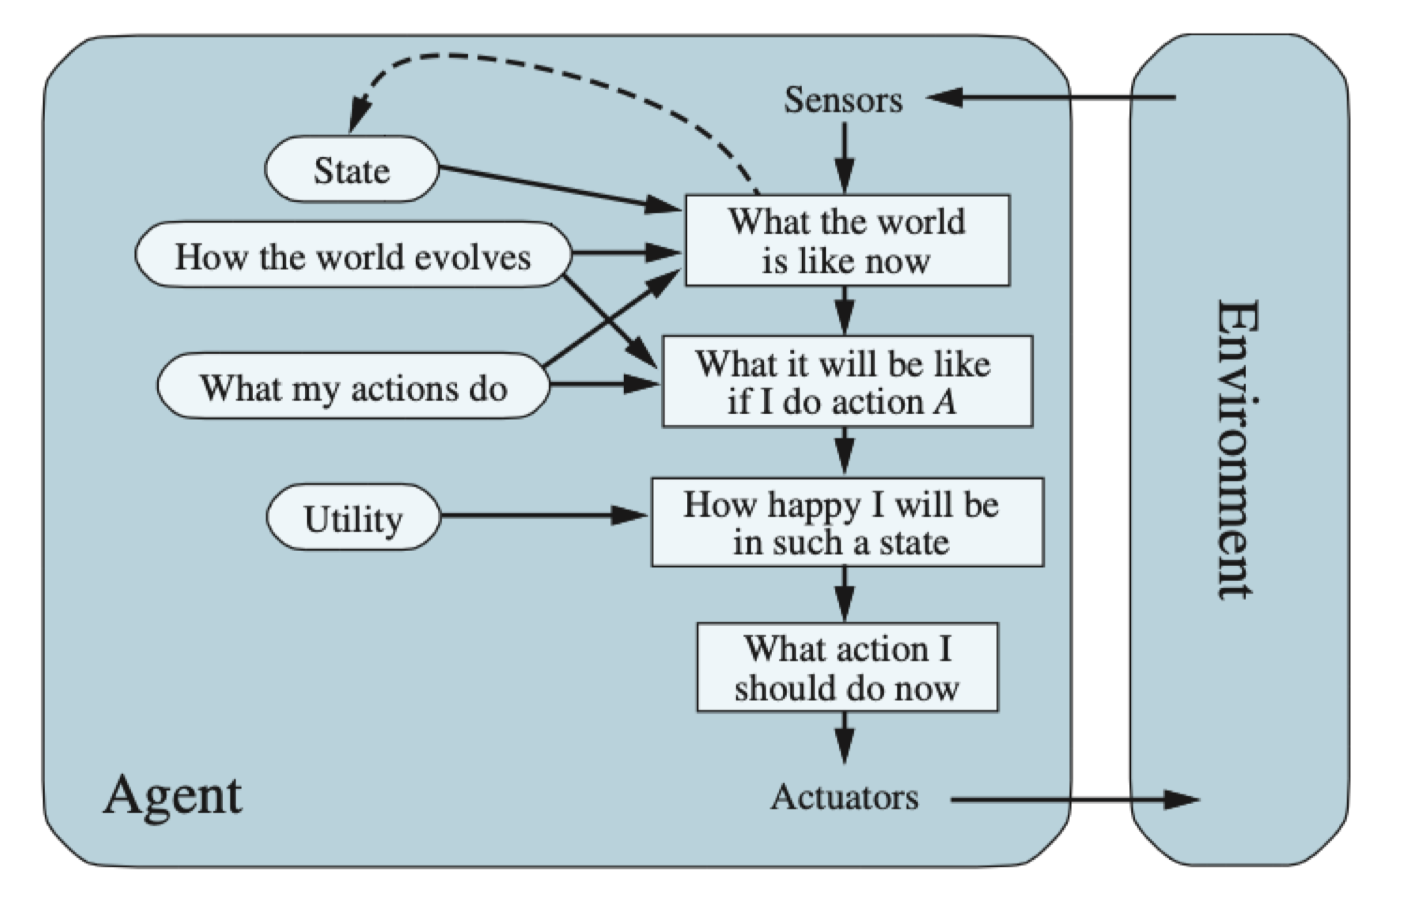
计算资源有限时可讨论有限理性(bounded rationality);它与“只找到局部最优”不同。“根据当前信息最大化期望效用”也不等于局部优化。
学习型(Learning Agents)
学习使智能体能够适应起初未知的环境,并通过经验改善表现。典型结构包含四部分:
- Performance element:选择对外行动。
- Learning element:根据经验改进模型或决策机制。
- Critic:按照性能标准提供反馈。
- Problem generator:建议能带来新信息的探索行动。
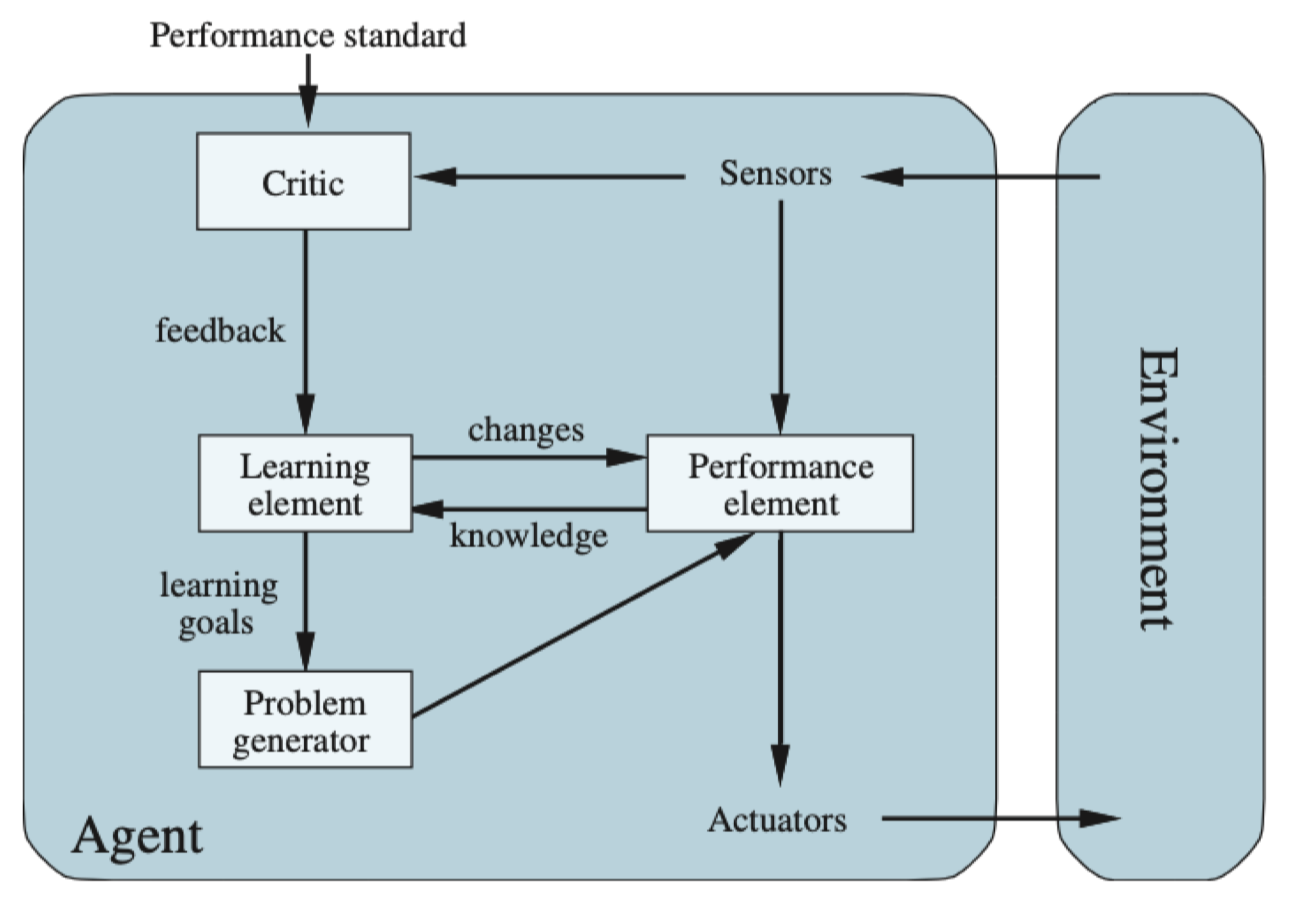
效用函数可视为性能目标的内部表示:在多个目标冲突时,它表达不同结果之间的权衡;在成功与否不确定时,它同时考虑成功概率与结果的重要性。学习则可以修改模型、规则、评估或行动策略,使各组件与反馈信息更一致,改善整体性能。学习元件根据评价元件的反馈改进执行元件,问题生成器则建议有信息价值的探索行动。
1.7 状态与信息表示
原子式、因子式与结构化表示
- 原子式(atomic):算法将状态视为不可拆分的整体,例如把每个棋局编码成一个状态编号。
- 因子式(factored):用变量及其取值表示状态,例如位置、速度、交通灯颜色。
- 结构化(structured):显式表示对象及其关系,例如“杯子在桌上”“椅子靠近桌子”。
这是建模与算法使用状态的方式,不意味着原子式状态在现实中没有内部结构。
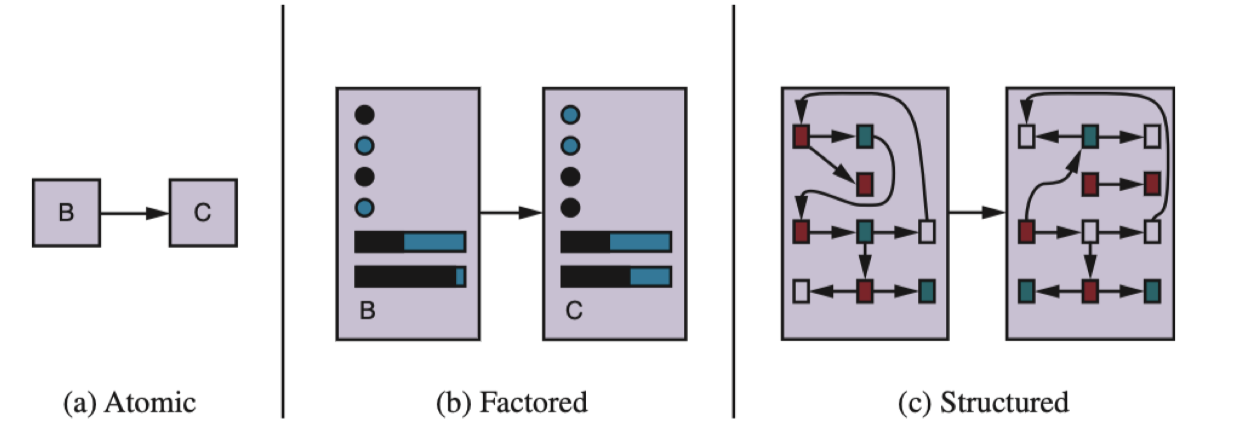
局部式与分布式表示
局部式表示(localist representation)用专门单元表示某个概念,例如 one-hot 编码。分布式表示(distributed representation)用多个单元共同编码一个概念,同一单元也参与表示不同概念。后者可以共享统计信息并形成相似性结构;抗噪与容错能力取决于编码方式及训练过程,不能无条件保证。
在查找表式强化学习中,原子式状态可以直接作为表的索引。因子式自动驾驶状态可写成位置、速度、交通灯颜色与邻车距离的组合;结构化机器人状态则可以同时列出桌子、椅子、杯子等对象,以及“杯子在桌上”“椅子靠近桌子”等关系。局部式编码强调概念与专门存储位置的对应;分布式编码强调一个概念跨多个存储位置、每个位置又参与多个概念的表示。
因子式表示中的变量取值可以是布尔值、实数或固定长度向量。例如位置可采用 GPS 坐标,速度可用 km/h,交通灯状态取红、绿、黄,邻车距离为数值。原子式表示中的查找表(lookup table)把整个状态编号当作访问键;结构化表示进一步区分对象身份和对象之间的关系。
Lecture 2: Uninformed Search
2.1 反射型与规划型智能体
反射型智能体依据当前感知或内部状态直接选行动;规划型智能体进一步问“如果这样做,会发生什么”,用环境模型推演未来。规划可以先产生完整计划,也可以边规划边执行;环境变化、模型误差或新观测可能触发重新规划(replanning)。
- 完备性(completeness):若存在解,算法在其适用条件下能否保证找到一个解。
- 最优性(optimality):能否保证找到代价最小的解。
完备不表示“把所有情形都列出来”,最优也不等于“最大化目标达成率”;在本章的确定性路径搜索中,最优指最小化路径代价。
2.2 搜索问题的组成
经典路径搜索通常假设:单智能体、确定性动作、已知转移模型、完全可观测状态和离散表示。其他类型的搜索需要扩展这一建模框架。
一个搜索问题包含:
- 状态空间 \(\mathcal{S}\)。
- 初始状态 \(s_0\)。
- 行动集合 \(A(s)\):每个状态下合法的行动。
- 转移模型 \(\operatorname{Result}(s,a)\):执行行动后的状态。
- 目标测试 \(\operatorname{GoalTest}(s)\)。
- 步代价 \(c(s,a,s')\):路径代价通常为步代价之和。
后继函数(successor function)可以把合法行动、后继状态和步代价一起返回。一个解是从初始状态到目标状态的行动序列;最优解是其中总代价最小者。代价必须与目标一致,例如最短路用步数或路程,而“吃掉豆子的个数”不能未经定义就直接当作要最小化的移动代价。
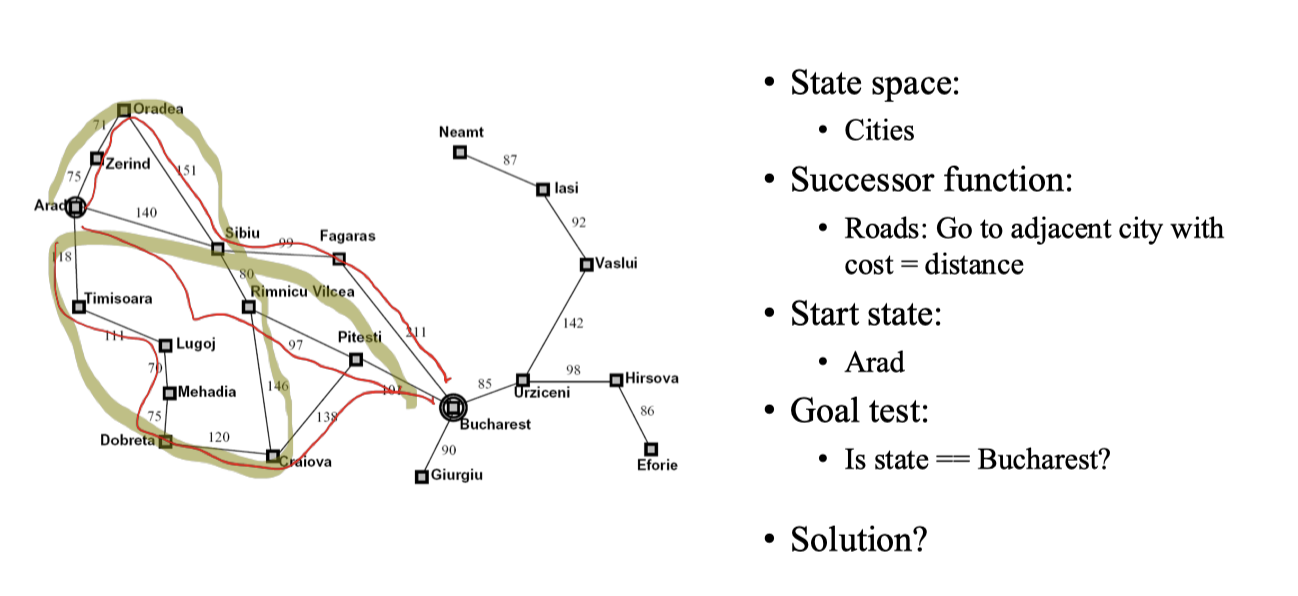
罗马尼亚旅行问题的逐项定义
- State space:图中各个城市。
- Successors:沿道路到达相邻城市,每条边给出道路距离。
- Start state:Arad。
- Goal test:当前城市是否为 Bucharest。
- Solution:从 Arad 到 Bucharest 的城市间行动序列;若以道路距离计代价,则比较各条路线的距离总和。
例如路线 \(\mathrm{Arad}\to\mathrm{Sibiu}\to\mathrm{Rimnicu\ Vilcea}\to\mathrm{Pitesti}\to\mathrm{Bucharest}\) 的长度为 \(140+80+97+101=418\)。它展示了如何把行动序列转成路径代价,而不是只比较经过城市的数量。
2.3 世界状态与搜索状态
世界状态(world state)包含环境细节;搜索状态(search state)保留规划所需的信息,形成抽象(abstraction)。被省略的信息不能影响所建模的合法行动、转移、目标和相关代价,否则抽象可能导致错误计划。
例如,在静态迷宫中单纯寻路时可忽略幽灵;若幽灵会阻挡、攻击或改变代价,就不能直接省略。
| 问题 | 搜索状态 | 后继变化 | 目标测试 |
|---|---|---|---|
| Pathing | Pac-Man 位置 \((x,y)\) | 合法地移动到相邻位置 | 到达指定位置 |
| Eat-All-Dots | 位置与剩余豆子的布尔向量 | 更新位置,并移除该位置的豆子 | 所有豆子都已吃完 |
两者都可以使用东、南、西、北移动,撞墙方向不属于合法动作。若有 \(L\) 个位置、\(D\) 颗豆子,状态数上界分别是 \(L\) 与 \(L2^D\);后者的全部组合未必都可达。
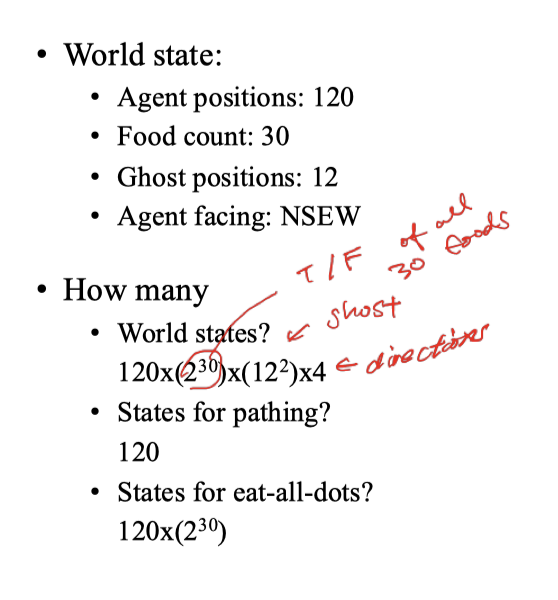
在 Eat-All-Dots 中,可令第 \(j\) 个布尔量 \(d_j\) 表示该豆子是否仍存在:初始有豆时为 true,进入对应位置后改为 false,目标为所有 \(d_j\) 都是 false。Pathing 的目标则是位置满足 \((x,y)=\mathrm{END}\)。
图中的规模例子有 \(120\) 个智能体位置、\(30\) 颗可独立存在或消失的豆子、两个各有 \(12\) 个位置选择的幽灵,以及智能体的 \(4\) 种朝向。按独立组合计数,世界状态数上界为
\[ 120\times2^{30}\times12^2\times4. \]
省略与静态寻路无关的豆子、幽灵和朝向后,Pathing 只需 \(120\) 个位置状态;Eat-All-Dots 则至多需要 \(120\times2^{30}\) 个位置—豆子组合。
2.4 状态空间图与搜索树
- 状态空间图(state-space graph):每个不同状态用一个顶点表示,边表示合法转移;可能有环。
- 搜索树(search tree):根表示起始状态,每个树节点对应一条从起点出发的路径,子节点表示把路径再延长一步。同一状态可以因不同路径而重复出现。
搜索节点通常还存储父节点、所用行动、深度和路径代价,不应与状态本身混为一谈。有限状态图也可能展开成无限搜索树,例如允许反复在环上移动时。
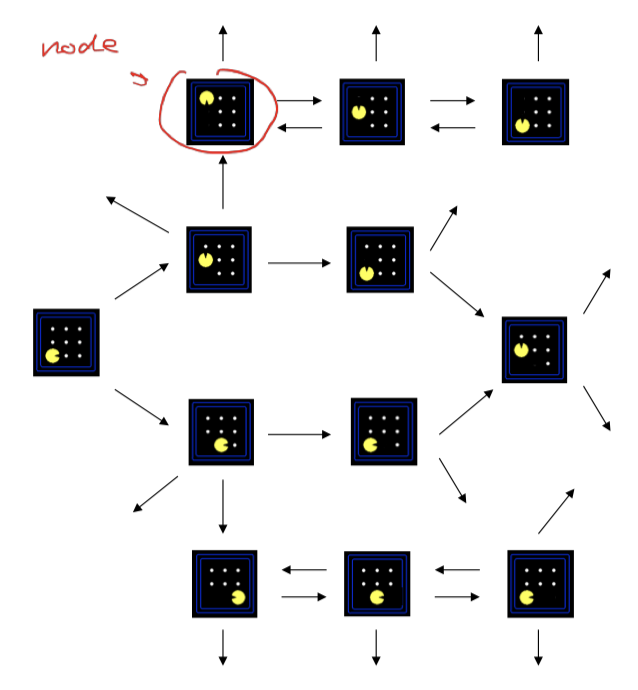
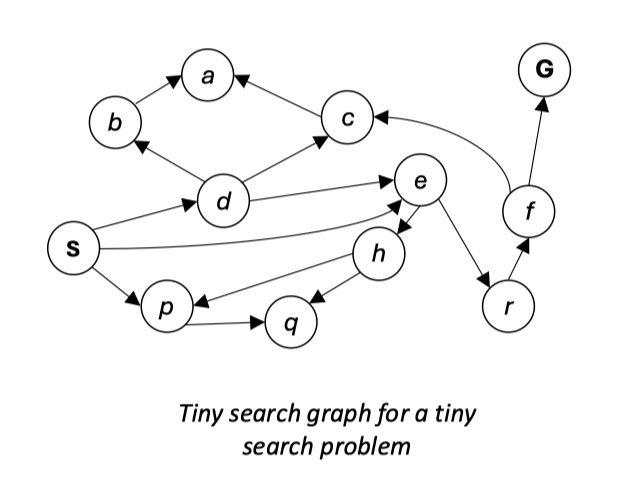
搜索树的根节点对应起点;一条树边对应一个行动;孩子节点对应执行该行动后到达的后继状态。一个或多个状态可以通过目标测试,成为目标节点。
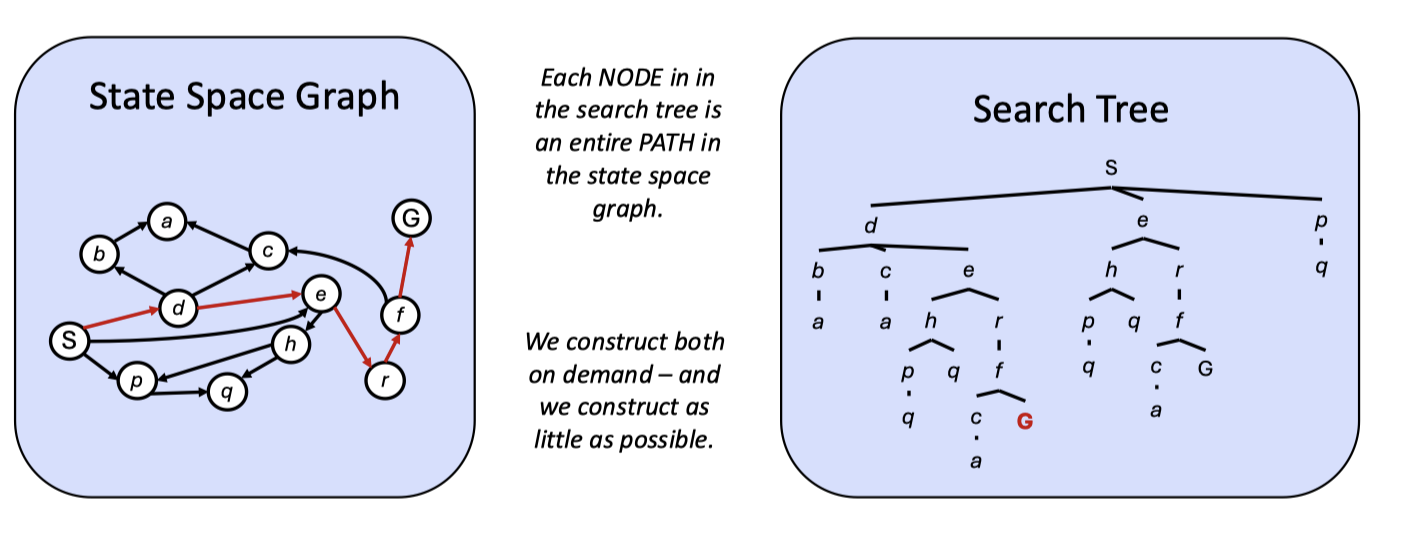
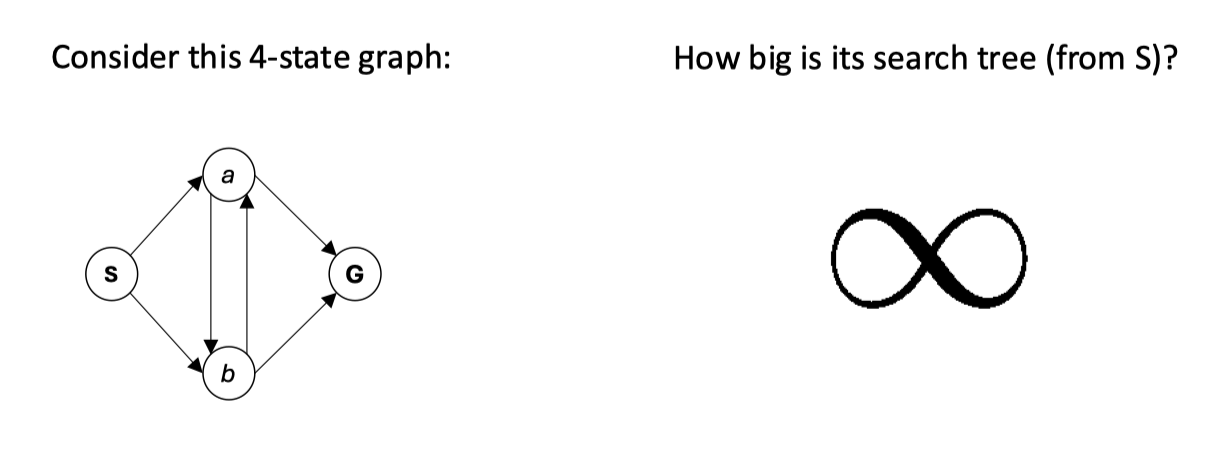
一般不会预先生成整个状态图或搜索树,而是在搜索过程中按需生成后继。
完整状态空间图通常太大,难以一次全部存入内存。按需构造后继可以只保留当前任务实际探索到的部分;搜索树中相同状态的重复前缀还会带来额外开销。
2.5 通用树搜索与图搜索
边缘集合(frontier/fringe)存放已生成、尚待处理的搜索节点。搜索策略决定下次取出哪个节点;扩展(expansion)指生成节点的后继。
TREE-SEARCH(problem, frontier):
    frontier.add(Node(problem.initial_state))
    while frontier is not empty:
        node ← frontier.pop()       # 按搜索策略选择
        if problem.is_goal(node.state):
            return reconstruct_path(node)
        for child in expand(node):
            frontier.add(child)
    return failure
图搜索(graph search)进一步处理重复状态。BFS、DFS 可以使用访问集合;UCS、A* 则要维护已知最小路径代价,必要时更新优先队列或重新打开状态,不能简单地在“第一次生成”时永久封闭它。
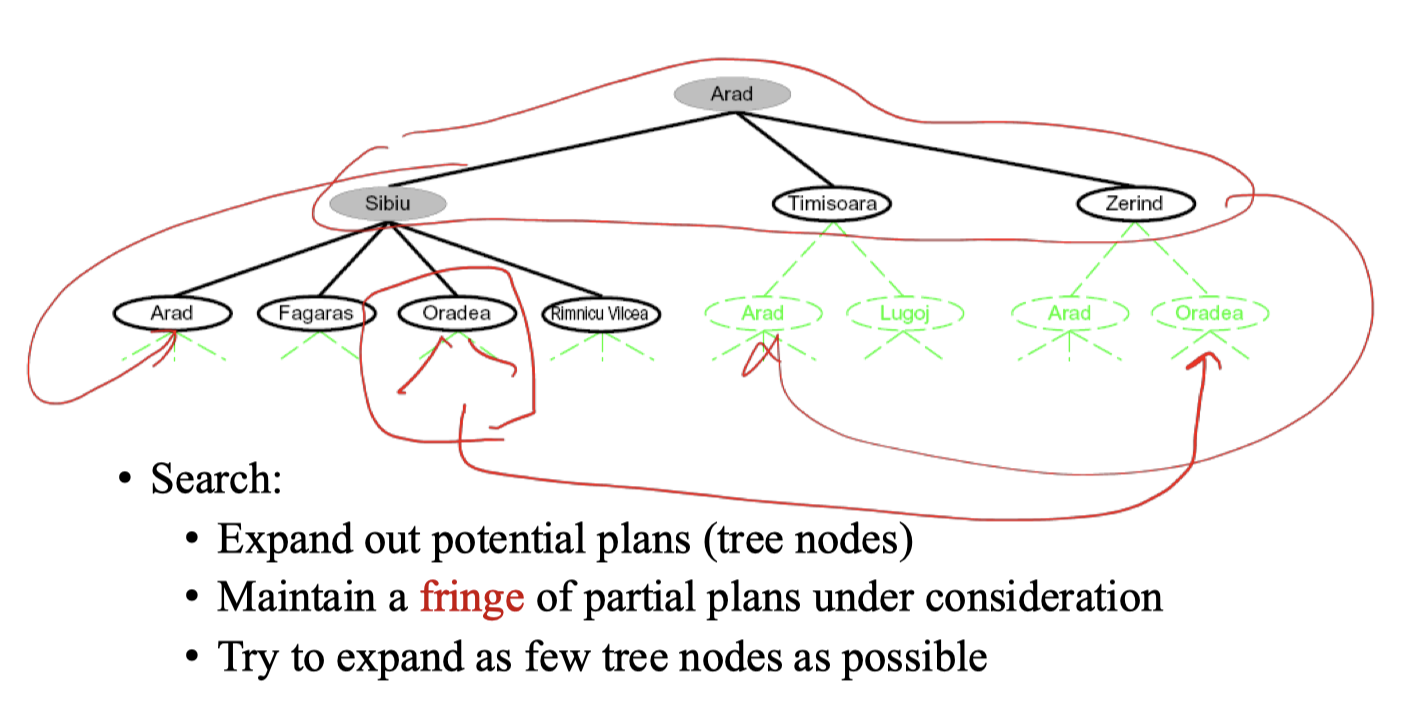
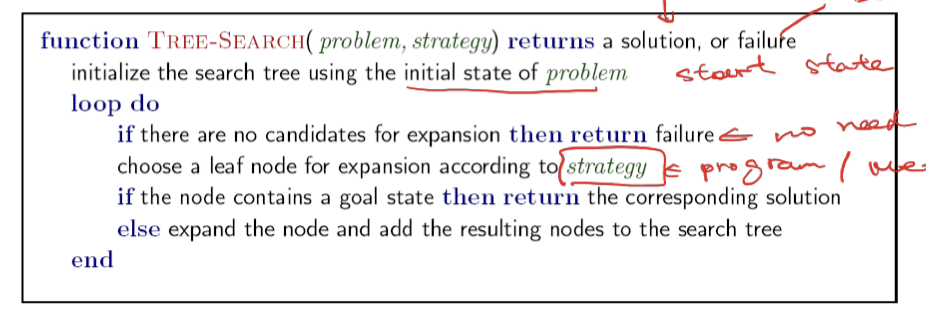
手动执行时可以按以下步骤检查:
- 创建包含初始状态的根节点,将它加入 frontier。
- 若 frontier 为空,则没有候选节点可处理,返回失败。
- 按策略取出一个候选叶节点,例如 BFS 取最浅者、DFS 取最深者、A* 取最小 \(g+h\) 者。
- 对该节点进行目标测试;成功时沿父指针还原行动序列。
- 若不是目标,生成其孩子并加入 frontier,然后回到第 2 步。
算法的完备性、最优性、时间复杂度与空间复杂度应分别评价。减少节点扩展通常能节省时间,但保留最优性或完备性也可能要求处理更多候选。
2.6 复杂度符号与计数约定
本章使用:
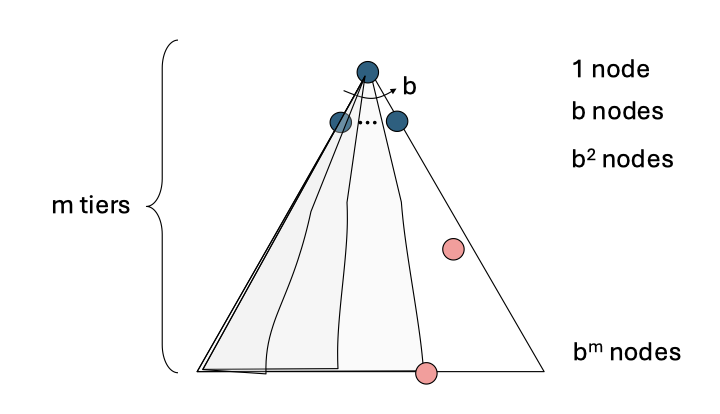
- \(b\):最大分支因子(每次扩展最多生成多少个后继),不是总节点数。
- \(d\):最浅目标的深度,根深度为 \(0\)。
- \(m\):搜索树的最大深度,可能为无穷。
- \(C^*\):最优解路径代价。
- \(\varepsilon>0\):步代价的统一正下界。
当 \(b>1\),深度至多为 \(m\) 的满树节点数为
\[ 1+b+\cdots+b^m=\frac{b^{m+1}-1}{b-1}=O(b^m). \]
当 \(b=1\),节点数是 \(m+1\),需要单独计算。
计数约定:BFS 若在生成目标时检测,可给出时间和空间 \(O(b^d)\);若按上方通用伪代码在出队时才检测,则可能先生成深度 \(d+1\) 的节点,保守上界为 \(O(b^{d+1})\)。这两种实现采用不同的目标检测时机,因此复杂度上界相差一层。
2.7 深度优先搜索(Depth-First Search, DFS)
DFS 优先处理最深的 frontier 节点,通常使用后进先出(LIFO)栈。它先深入一个分支,再回溯处理其他分支;“先左后右”只是子节点入栈顺序造成的约定。
下面统一规定栈顶在右侧:
初始:                   [S]
弹出 S,依次压入 A,B,C:  [A, B, C]
弹出 C,依次压入 C1,C2:  [A, B, C1, C2]
下一次弹出: C2- 时间:有限深度树最坏为 \(O(b^m)\)。
- 空间:显式保存每层待探索兄弟节点时为 \(O(bm)\);逐个生成后继的递归实现可降低额外栈空间。若额外保存全局访问集合,还要计入该集合的空间。
- 完备性:有限树上完备;无限深分支或无重复检测的环可能使其不终止。有限状态图上,正确避免重复的图搜索版本完备。只限制一个固定深度,不能保证找到界限之外的解。
- 最优性:一般不保证;第一个找到的解可能很深或代价很高。
上述栈例题下一步弹出 \(C2\),先处理 \(C2\) 的整个子树;之后处理仍在栈中的 \(C1\) 及其子树,再回到 \(B\),最后到 \(A\)。若希望优先访问图上最左侧的孩子,应按与期望访问次序相反的顺序压栈。栈顶约定与入栈次序必须保持一致,才能准确推演 DFS 的遍历顺序。
2.8 广度优先搜索(Breadth-First Search, BFS)
BFS 使用先进先出(FIFO)队列,按深度逐层搜索,保证首先找到最浅的目标。
- 时间与空间:生成时检测目标通常为 \(O(b^d)\);出队时检测的保守上界为 \(O(b^{d+1})\)。
- 完备性:分支因子有限、某个解深度有限时完备。树搜索即使遇到环,也会按层推进;图搜索还可避免重复工作。
- 最优性:所有步代价相同且为正时,最浅解也是最小代价解。不是要求“所有完整路径的代价都相等”。
BFS 适合解较浅、内存足够的任务;DFS 适合空间受限或较深路径可能迅速找到解的任务。是否更快取决于搜索结构与子节点顺序;BFS 和 DFS 都可以加入重复检测。
BFS 与 DFS 的逐情形比较
- 目标较浅且每步等价:BFS 先检查浅层,保证找到最少步数的解;DFS 可能先进入很深的非目标分支。
- 有限空间且目标离根较近:BFS 往往避免在一个深分支中投入过多工作;是否更快仍取决于具体结构。
- 存在环:无重复处理的 DFS 可能反复沿环深入;BFS 树搜索按层推进,但也会重复生成状态。两者都可加入图搜索的重复检测。
- 搜索空间大、内存紧张:BFS 要保存整层 frontier;DFS 主要保存当前路径及待探索兄弟节点,通常更节省空间。
- 目标很深且恰在优先探索的分支:DFS 可能很快碰到目标,而 BFS 要先处理全部较浅层。但 DFS 在其他分支顺序下也可能很慢。
2.9 迭代加深搜索(Iterative Deepening Search, IDS)
依次运行深度受限 DFS,深度界限为 \(0,1,2,\ldots\),直到找到解。若某次受限搜索已证明整个可达空间耗尽,应报告失败,而非继续增加界限。
当 \(b>1\) 时,主要工作集中在最深一层,重复搜索较浅层不会改变 \(O(b^d)\) 的时间数量级;空间为 \(O(bd)\)。有限分支条件下,它能找到最浅解;步代价相同且为正时保证最优。它结合了 BFS 的浅层解保证与 DFS 的空间优势。
例如深度界限依次增加时:
- 界限 \(0\):只检查起点是否已经满足目标。
- 界限 \(1\):搜索到一层动作;若因界限截断而未找到目标,则提高界限。
- 界限 \(2\):从起点重新执行 DFS,允许到第二层。
- 界限 \(3\):再次重新搜索,允许到第三层,如此继续。
这适用于目标深度未知、内存不足以保存 BFS 全层 frontier 的情况。
2.10 一致代价搜索(Uniform-Cost Search, UCS)
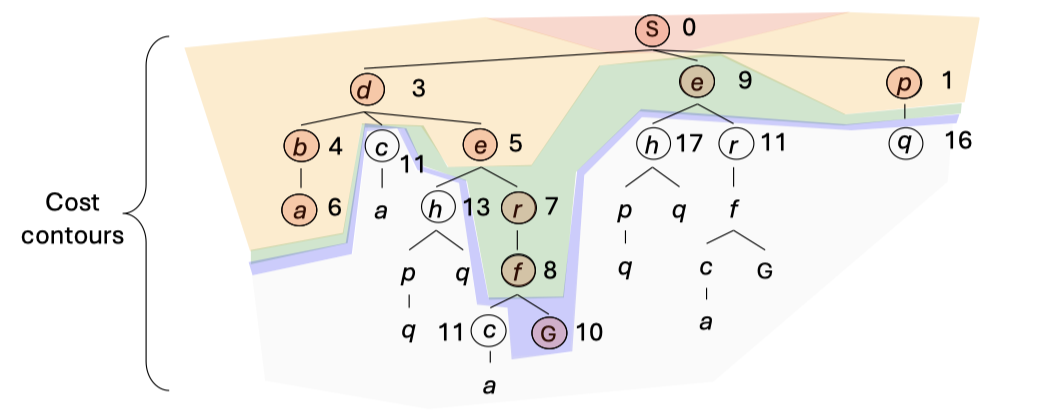
UCS 使用按 \(g(n)\) 排序的优先队列,每次取出已走路径总代价最小的节点。
\[ g(n)=\sum_{\text{edges on path to }n}c(s,a,s'). \]
需要在目标节点以当前最小代价从队列弹出时终止。若同一状态出现更便宜的路径,要更新记录;使用允许重复条目的堆时,应跳过过期条目。
- 最优性:非负步代价下,正确实现的 UCS 返回的解为最小代价解。
- 完备性:无限空间中,通常要求有限分支、有限最优解代价,且所有步代价满足 \(c\geq\varepsilon>0\)。仅说“每条边都大于零”不够,因为无穷多条递减正代价的边仍可能让搜索停留在某个代价界内。有限图配合重复处理时,可允许零代价边。
- 时间与空间:在上述统一正下界条件下,常用保守上界为
\[ O\!\left(b^{1+\lfloor C^*/\varepsilon\rfloor}\right). \]
它描述可能生成的搜索树节点数量;优先队列操作还可能引入对数因子。UCS 会处理所有优先级严格低于 \(C^*\) 的可达候选路径,并可能处理部分等于 \(C^*\) 的候选;重复检测会合并状态。
UCS 不利用目标方向,可能探索许多低代价却远离目标的状态。Dijkstra 算法与它共享最小累计代价优先的核心原则。
在代价轮廓图中,起点 \(S\) 的累计代价为 \(0\)。其候选节点如 \(p\) 的代价为 \(1\)、\(d\) 的代价为 \(3\),UCS 会先处理较低累计代价者。相同代价的候选之间可以采用固定平局规则;它们在几何位置上不一定离起点一样远。UCS 不知道目标方位,所以即使某条低代价分支暂时远离目标,也可能继续扩展它。
Lecture 3: Informed Search
3.1 启发式函数(Heuristic Function)
\(h(n)\) 估计从节点 \(n\) 所对应状态到目标的最小剩余代价,其单位应与路径代价一致。例如,最短路代价为米时,不应直接把“估计分钟数”与它相加。
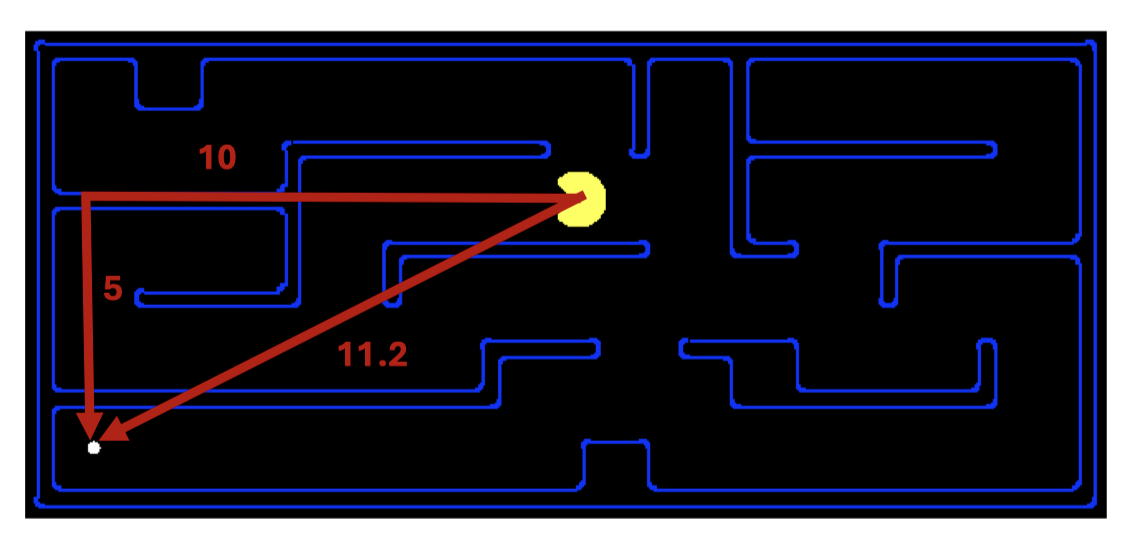
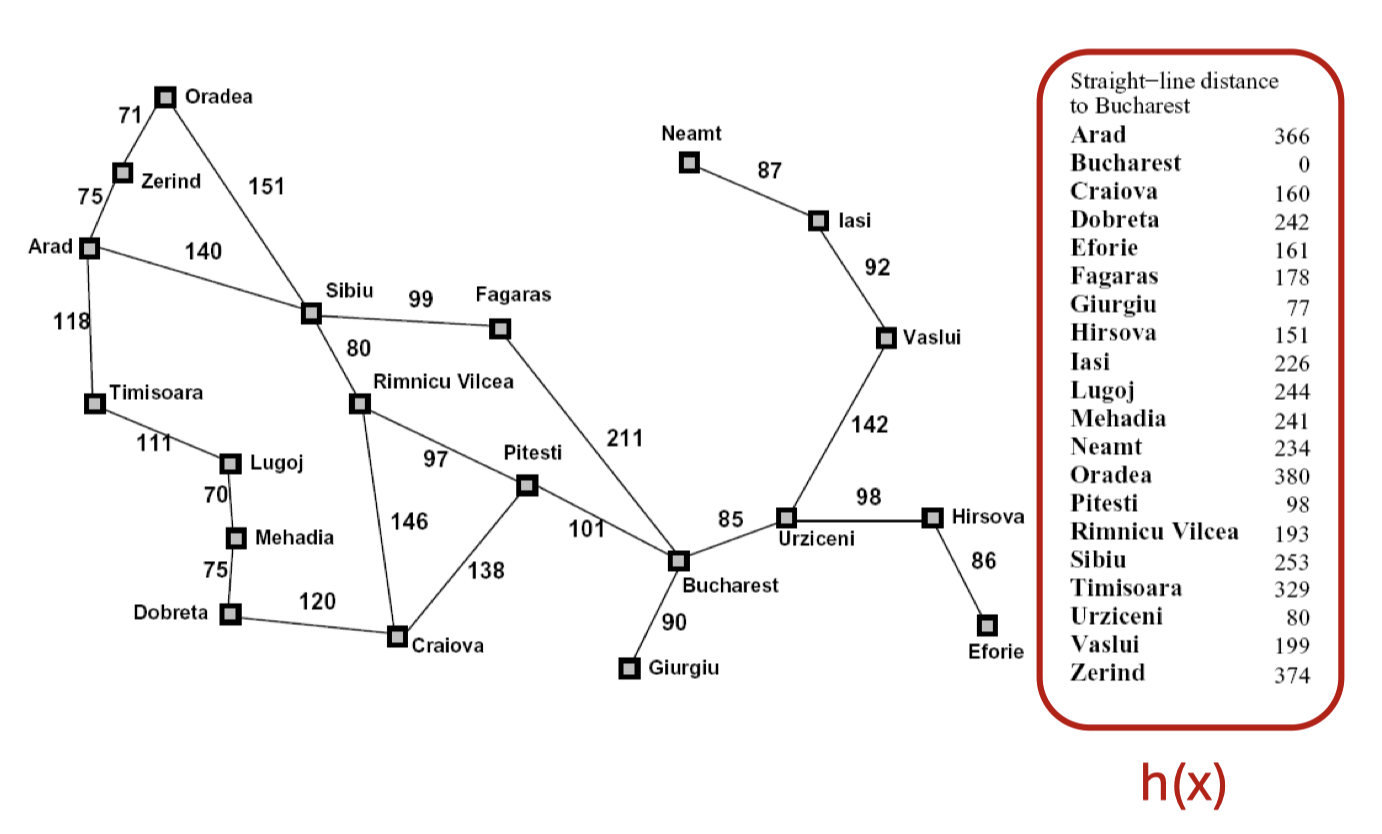
网格距离与直线距离
对于位置 \((x,y)\) 和目标 \((x_g,y_g)\):
\[ h_{\text{Manhattan}}=|x-x_g|+|y-y_g|, \]
\[ h_{\text{Euclidean}}=\sqrt{(x-x_g)^2+(y-y_g)^2}. \]
在每步代价为 \(1\)、只允许上下左右移动的单位网格中,忽略障碍物后的曼哈顿距离是可采纳的下界。允许对角移动、存在传送门或改变步代价时,需要重新检查下界性质。道路距离不小于直线距离时,直线距离也可作为最短路的下界。
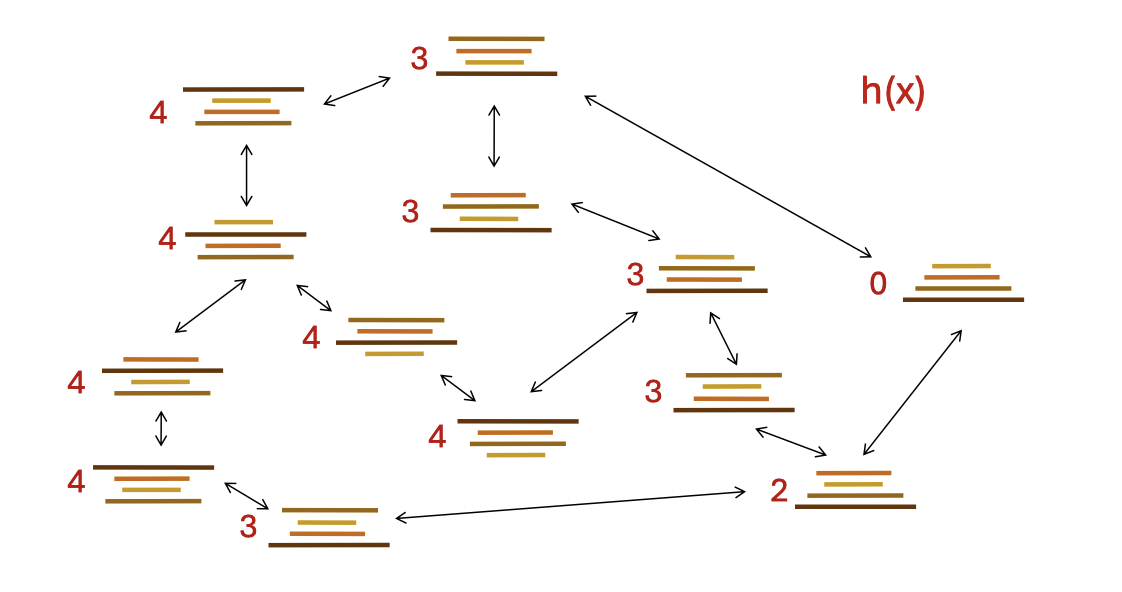
煎饼排序(Pancake Sorting)
状态是一叠不同大小煎饼的排列;行动是翻转顶部若干张,目标是按大小排好。图中的启发式取“仍未归位的最大煎饼编号”,全部归位时为 \(0\)。最大的一张已归位时,还要继续检查其余煎饼,不能立即令 \(h=0\)。
设定翻转顶部 \(k\) 张的代价为 \(k\)。若最大的未归位煎饼编号为 \(j\),要把它放回第 \(j\) 个位置,至少需要一次长度不小于 \(j\) 的翻转,因此该估计是下界。若改用单位翻转代价,该函数可能高估,例如一次翻转就能排好却给出 \(h=4\)。
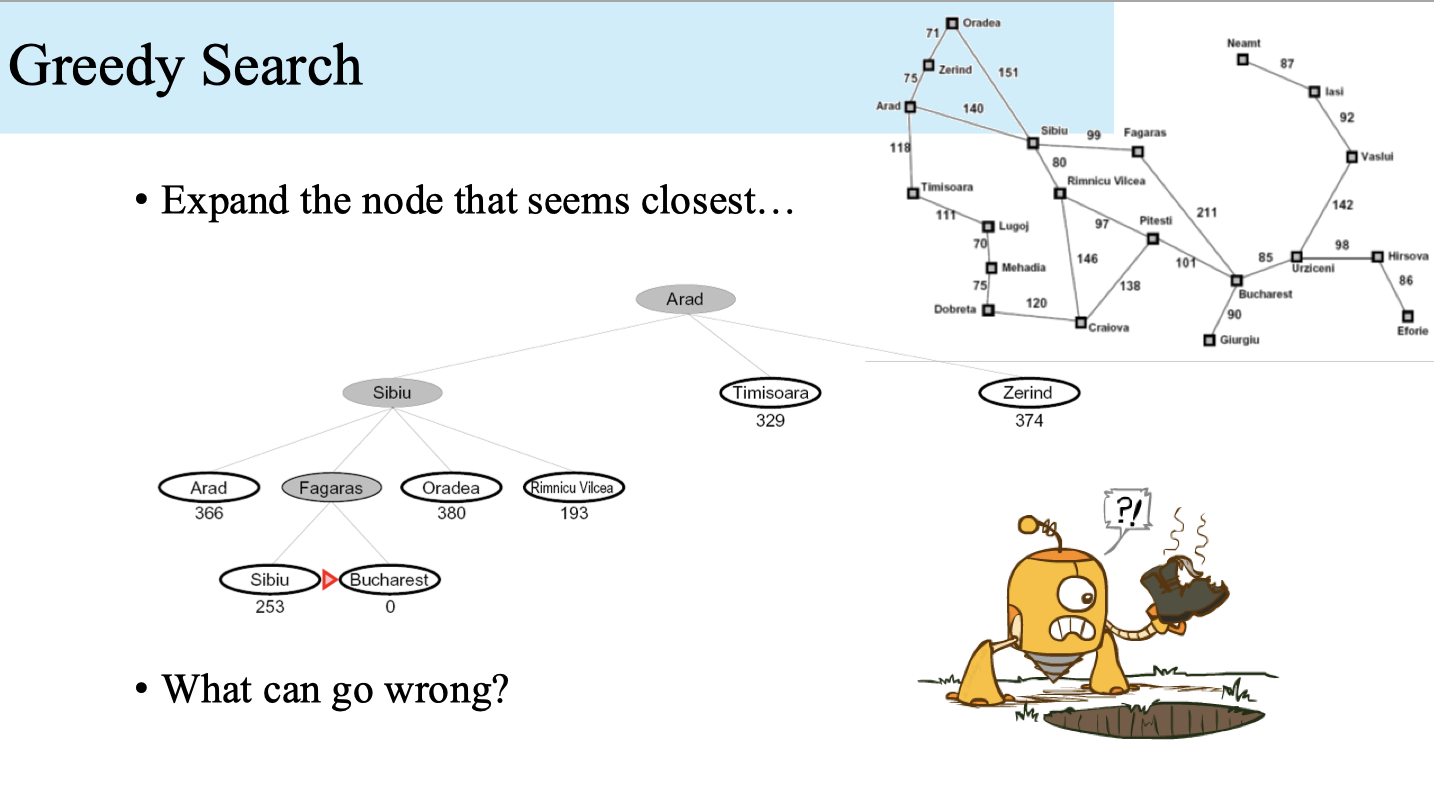
3.2 贪心最佳优先搜索(Greedy Best-First Search)
每次选择 \(h(n)\) 最小的 frontier 节点,忽略已经付出的代价 \(g(n)\)。它可能很快接近目标,也可能被错误的估计引到长路径或无限分支。一般不保证最优;无限空间中不保证完备。有限状态图上,正确处理重复状态且最终处理全部候选时可以保证完备。
3.3 A* 搜索
A* 用下式作为优先级,每次选择 \(f(n)\) 最小的节点:
\[ f(n)=g(n)+h(n). \]
| 搜索方法 | 优先级 | 使用的信息 |
|---|---|---|
| UCS | \(g(n)\) | 已走代价 |
| Greedy | \(h(n)\) | 剩余代价估计 |
| A* | \(g(n)+h(n)\) | 已走代价与剩余代价估计 |
当 \(h\equiv0\) 时,A* 退化为 UCS。启发式提供的是代价估计,并不一定是几何距离。
为什么不能在生成目标时立即终止
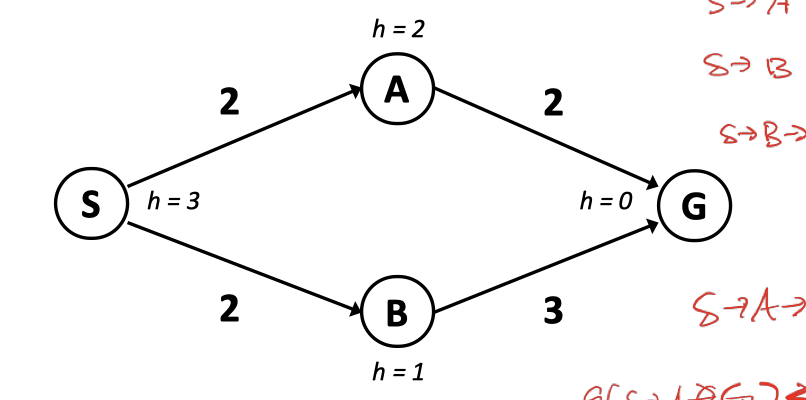
图中 \(S\to A\) 和 \(S\to B\) 的代价均为 \(2\),\(A\to G\) 为 \(2\),\(B\to G\) 为 \(3\),且 \(h(A)=2,h(B)=1,h(G)=0\):
- 扩展 \(S\) 后,\(f(A)=2+2=4\),\(f(B)=2+1=3\),先弹出 \(B\)。
- 经 \(B\) 生成目标路径,\(g(G)=5\),但此时 frontier 中仍有 \(f(A)=4\)。
- 弹出 \(A\),找到更便宜的目标路径,\(g(G)=4\),更新目标记录。
- 再弹出代价 \(4\) 的有效目标节点,返回 \(S\to A\to G\)。
这条终止规则还须配合下文的启发式条件与正确的重复状态处理,才能保证最优。
用优先队列逐步记录上述 A* 例题,过程为:
| 步骤 | 取出节点 | 新计算 | frontier 的有效候选 |
|---|---|---|---|
| 扩展起点 | \(S\) | \(g(A)=2,g(B)=2\) | \(B:f=3\),\(A:f=4\) |
| 扩展 \(B\) | \(B\) | \(g(G)=2+3=5\),\(f(G)=5+0=5\) | \(A:f=4\),\(G:f=5\) |
| 扩展 \(A\) | \(A\) | \(g(G)=2+2=4\),\(f(G)=4+0=4\) | 更新后的 \(G:f=4\) |
| 目标出队 | \(G\) | 最小有效目标代价为 \(4\) | 返回 \(S\to A\to G\) |
若堆中仍留着旧的 \(G:f=5\) 条目,它是过期候选,不应覆盖代价更小的记录。
3.4 可采纳性(Admissibility)
记 \(h^*(n)\) 为从 \(n\) 的状态到最近目标的真实最小剩余代价。非负启发式的可采纳性条件为:
\[ 0\leq h(n)\leq h^*(n). \]
满足该条件的启发式称为可采纳(admissible),即不高估剩余代价。目标处有 \(h(G)=0\)。
\(g(n)\) 是起点到当前节点的已走代价,\(h^*(n)\) 是当前节点到目标的最优剩余代价。判断是否高估应比较 \(h(n)\) 与 \(h^*(n)\);\(h(n)>g(n)\) 本身不是错误。
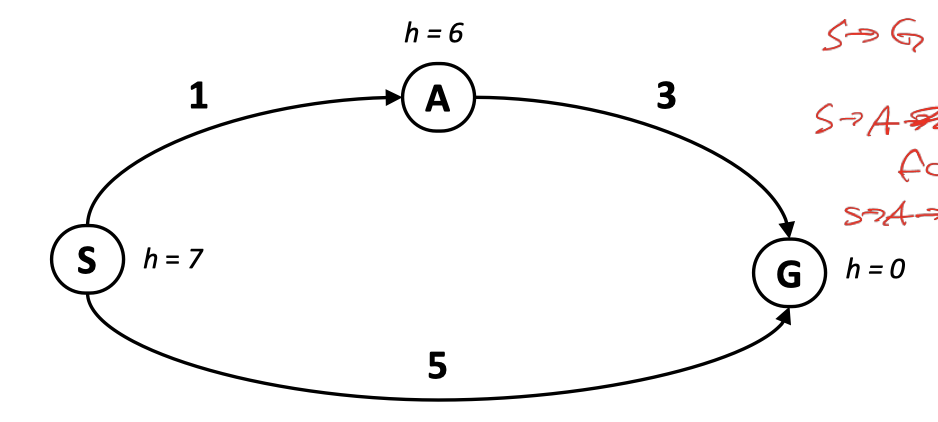
在该例中,\(S\to A\to G\) 真实代价为 \(1+3=4\),但 \(f(A)=1+6=7\);直接路径 \(S\to G\) 的 \(f=5\)。A* 因高估而先弹出次优目标,失去最优性保证。不可采纳并不意味着每次都失败,而是不能普遍保证最优。
A* 树搜索最优性证明
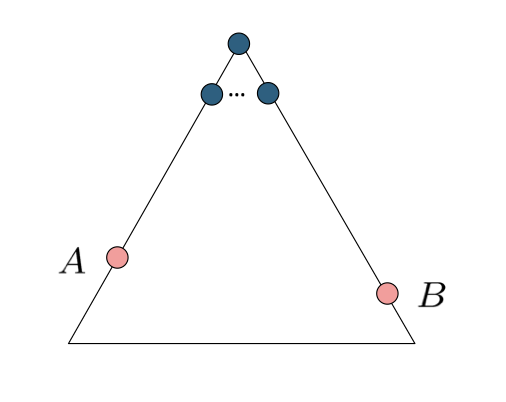
设最优目标节点为 \(A\),其路径代价为 \(C^*\);假设某次准备弹出次优目标 \(B\),则 \(g(B)>C^*\)。在通往 \(A\) 的最优路径上,必有一个尚在 frontier 的节点 \(n\)(可能就是 \(A\))。由可采纳性:
\[ f(n)=g(n)+h(n)\leq g(n)+h^*(n)=C^*. \]
而目标处 \(h(B)=0\),所以
\[ f(n)\leq C^*<g(B)=f(B). \]
这与 \(B\) 是最小 \(f\) 节点矛盾。因此算法不会先返回次优目标。证明还依赖最优路径上的候选没有被错误删除;要保证最终找到目标,通常再要求有限分支、步代价存在统一正下界等终止条件。
最优性证明的逐步不等式
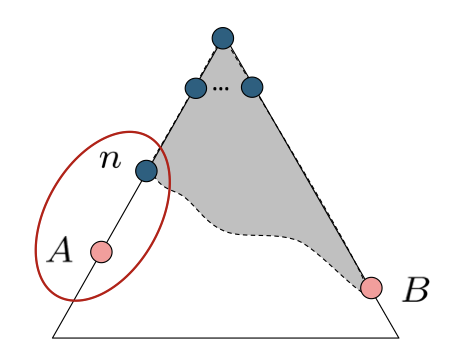
- 对最优路径上的 frontier 节点 \(n\),由 \(h(n)\leq h^*(n)\):
\[ g(n)+h(n)\leq g(n)+h^*(n)=g(A). \]
由于目标 \(A\) 的 \(h(A)=0\),可得 \(f(n)\leq g(A)=f(A)\)。
- 由于 \(B\) 是次优目标:
\[ g(A)<g(B),\qquad h(A)=h(B)=0, \]
所以 \(f(A)<f(B)\)。
- 合并得到
\[ f(n)\leq f(A)<f(B). \]
因此只要 \(B\) 在 frontier,最优路径上的候选就有更小优先级,算法会先推进该路径。结合终止条件,最优目标会在任何次优目标之前出队。
3.5 一致性(Consistency)
启发式满足 \(h(G)=0\),且对每条合法边 \(x\to y\) 都有
\[ h(x)\leq c(x,y)+h(y), \]
则称其一致(consistent)。这里 \(c(x,y)\) 是单步代价,避免与已走总代价 \(g(n)\) 混淆。
沿任一路径都有
\[ f(y)=g(x)+c(x,y)+h(y)\geq g(x)+h(x)=f(x). \]
因此 \(f\) 沿路径不下降。对非负代价问题,使用一致启发式时,A* 第一次以有效最小优先级弹出某状态,就已经找到到该状态的最小代价;可以在此时将状态封闭而不再重新扩展。
一致性推出可采纳性
取一条从 \(n=n_0\) 到目标 \(n_k=G\) 的最优路径。逐边使用一致性并相加:
\[ h(n)\leq\sum_{i=0}^{k-1}c(n_i,n_{i+1})+h(G)=h^*(n). \]
结合启发式的非负性,得到可采纳性。反过来不成立:可采纳启发式仍可能违反局部三角不等式。
也可把一致性逐边展开。令最优路径为
\[ n=n_0\to n_1\to\cdots\to n_k=G. \]
对每条边分别有
\[ h(n_i)\leq c(n_i,n_{i+1})+h(n_{i+1}). \]
先展开第一条,再代入第二条,得到
\[ \begin{aligned} h(n_0)&\leq c(n_0,n_1)+h(n_1)\\ &\leq c(n_0,n_1)+c(n_1,n_2)+h(n_2)\\ &\leq\cdots\\ &\leq\sum_{i=0}^{k-1}c(n_i,n_{i+1})+h(G). \end{aligned} \]
最后使用 \(h(G)=0\),右侧正是最优剩余路径代价 \(h^*(n)\),从而得到可采纳性。
3.6 A* 图搜索的实现条件
- 只保证可采纳:若发现到已扩展状态的更低代价路径,可能需要重新打开该状态(reopen)。
- 启发式一致:正确维护最小路径代价后,不必重新打开已弹出的状态;但生成阶段仍要允许降低 frontier 中状态的路径代价。
- 无论哪种情况:不要在第一次生成状态时就永久禁止改进。
A-STAR(problem, h):
    best_g[start] ← 0
    push(frontier, Node(start, g=0), priority=h(start))
    while frontier is not empty:
        node ← pop_min(frontier)
        if node.g > best_g[node.state]:
            continue                         # 过期条目
        if is_goal(node.state):
            return reconstruct_path(node)
        for (action, successor, cost) in successors(node.state):
            new_g ← node.g + cost
            if successor not in best_g or new_g < best_g[successor]:
                best_g[successor] ← new_g
                child ← Node(successor, parent=node, action=action, g=new_g)
                push(frontier, child, priority=new_g + h(successor))
    return failure
该版本允许同一状态在更低 \(g\) 出现后重新扩展,可用于可采纳但不一致的启发式。无解的无限状态空间中,算法未必会终止。
3.7 启发式设计与搜索效率
通过放松问题(relaxation),例如去除障碍物或取消部分约束,可得到不超过原问题最优代价的估计。多个可采纳启发式的最大值仍可采纳:
\[ h(n)=\max\{h_1(n),\ldots,h_k(n)\}. \]
启发式越接近真实剩余代价,通常越有指导作用,但计算它也要花时间。A* 仍可能在最坏情况下消耗指数级时间和大量内存;不能仅因它使用启发式,就断言一定比 UCS 快。UCS 按 \(g\) 的轮廓推进,A* 按 \(g+h\) 的轮廓推进。
Lecture 4: Probability
4.1 随机变量与分布
随机变量(random variable)把随机试验的结果映射为取值,例如 \(R\) 表示是否下雨,\(T\) 表示冷热,\(D\) 表示通勤时间。通常用大写字母表示变量,小写字母表示具体值:
\[ R\in\{\mathrm{true},\mathrm{false}\},\qquad T\in\{\mathrm{hot},\mathrm{cold}\},\qquad D\in[0,\infty). \]
离散分布可用概率表表示,满足
\[ P(X=x)\geq0,\qquad\sum_xP(X=x)=1. \]
\(P(X)\) 常表示整个分布,而 \(P(X=x)\) 是一个具体概率。连续变量通常用密度表示,密度积分为 \(1\);密度值本身不是单点概率,通常 \(P(D=d)=0\)。
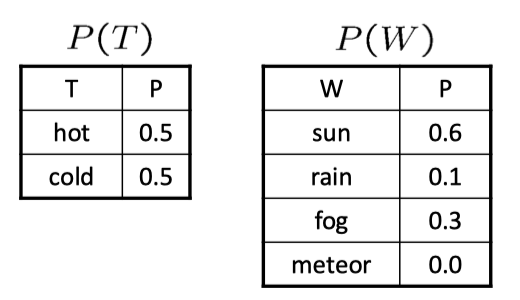
温度示例为 \(P(T=\mathrm{hot})=P(T=\mathrm{cold})=0.5\)。另一个独立的天气分布示例如下,注意晴天值是 sun,不是 hot:
| \(W\) | sun | rain | fog | meteor |
|---|---|---|---|---|
| \(P(W)\) | 0.6 | 0.1 | 0.3 | 0.0 |
零概率表示该模型给这个事件的概率为零,不应据此推断现实中绝对不可能。
还可以用位置变量 \(L\) 表示“幽灵在哪里”,其取值域是允许的地图位置;随机变量的取值可以是类别、数值或位置,而不仅是布尔值。
4.2 联合分布(Joint Distribution)
\(P(X_1,\ldots,X_n)\) 描述多个变量联合取值的概率。若第 \(i\) 个变量有 \(d_i\) 个值,完整表有 \(\prod_i d_i\) 个条目;每个变量均有 \(d\) 个值时为 \(d^n\)。归一化使自由参数比条目数少 \(1\)。
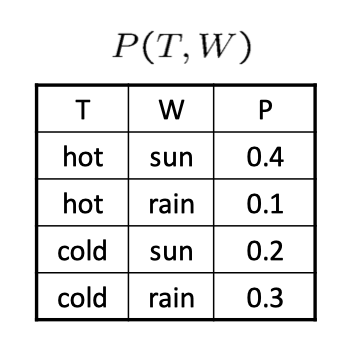
下面的温度—天气联合分布将在本讲反复使用。它与上节包含 fog、meteor 的天气示例属于不同模型:
| \(T\) | \(W\) | \(P(T,W)\) |
|---|---|---|
| hot | sun | 0.4 |
| hot | rain | 0.1 |
| cold | sun | 0.2 |
| cold | rain | 0.3 |
概率模型对各种赋值的可能性进行量化;CSP 则用约束区分允许与禁止的赋值。CSP 不需要归一化的概率,但可以扩展为概率或加权模型。
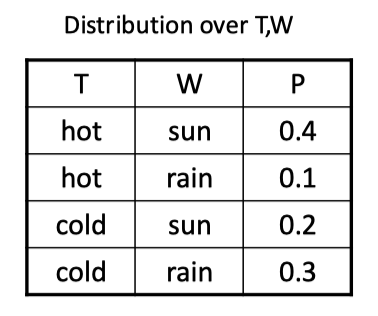
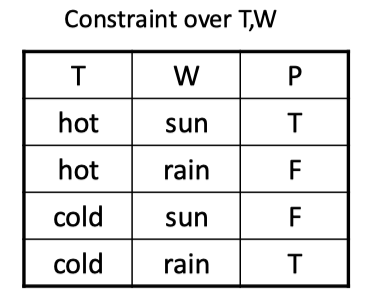
逐项比较两类模型:变量都具有域;一次完整 assignment 对应一个联合取值结果;概率模型量化这个结果的可能性并归一化,CSP 只判断它是否满足约束。概率模型还可用独立性结构减少表示与推断成本,但不要求所有变量独立。
4.3 样本空间与事件
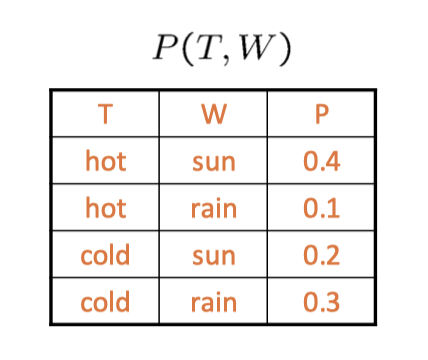
样本空间(sample space)\(\Omega\) 包含所有可能结果,事件(event)是其子集。对于上表:
\[ \Omega=\{(\mathrm{hot},\mathrm{sun}), (\mathrm{hot},\mathrm{rain}), (\mathrm{cold},\mathrm{sun}), (\mathrm{cold},\mathrm{rain})\}. \]
离散情形中,事件概率是其包含结果的概率之和。事件可以为空集、单个结果或整个样本空间。
\[ P(T=\mathrm{hot},W=\mathrm{sun})=0.4, \]
\[ P(T=\mathrm{hot})=0.4+0.1=0.5. \]
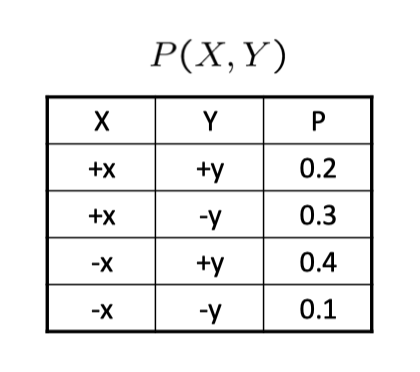
另一个二值变量示例中,\(+x\) 表示事件 \(X=\mathrm{true}\),\(-x\) 表示 \(X=\mathrm{false}\),不是数值正负号:
| \(X\) | \(Y\) | \(P(X,Y)\) |
|---|---|---|
| \(+x\) | \(+y\) | 0.2 |
| \(+x\) | \(-y\) | 0.3 |
| \(-x\) | \(+y\) | 0.4 |
| \(-x\) | \(-y\) | 0.1 |
由容斥公式:
\[ \begin{aligned} P(+x)&=0.2+0.3=0.5,\\ P(-y)&=0.3+0.1=0.4,\\ P((-y)\cup(+x))&=0.4+0.5-0.3=0.6. \end{aligned} \]
4.4 边际化(Marginalization)
对不关心的变量求和,得到其余变量的边际分布(marginal distribution):
\[ P(X=x)=\sum_yP(X=x,Y=y). \]
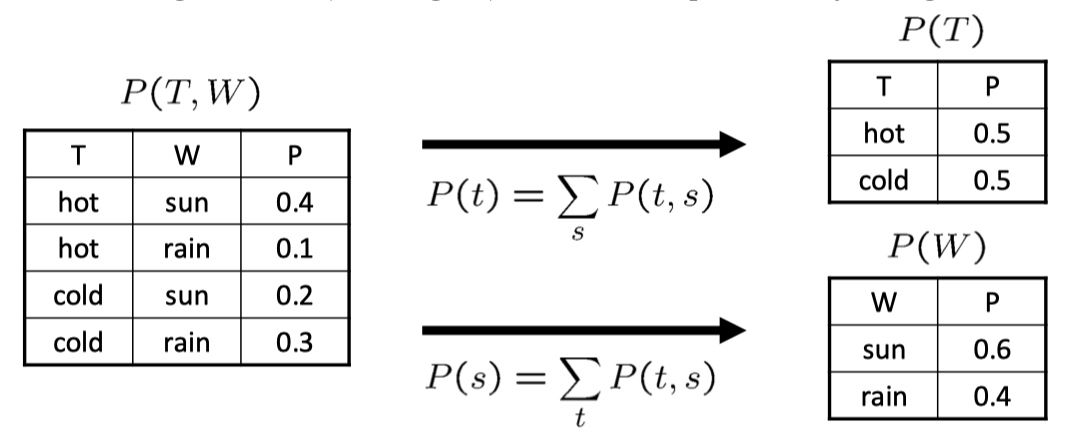
它不是简单地从表格中删除列;具有相同剩余取值的条目需要相加。温度—天气示例得到:
\[ P(T=\mathrm{hot})=0.5,\quad P(T=\mathrm{cold})=0.5, \]
\[ P(W=\mathrm{sun})=0.6,\quad P(W=\mathrm{rain})=0.4. \]
逐项计算为
\[ \begin{aligned} P(\mathrm{hot})&=P(\mathrm{hot},\mathrm{sun})+P(\mathrm{hot},\mathrm{rain})=0.4+0.1=0.5,\\ P(\mathrm{cold})&=P(\mathrm{cold},\mathrm{sun})+P(\mathrm{cold},\mathrm{rain})=0.2+0.3=0.5,\\ P(\mathrm{sun})&=P(\mathrm{hot},\mathrm{sun})+P(\mathrm{cold},\mathrm{sun})=0.4+0.2=0.6,\\ P(\mathrm{rain})&=P(\mathrm{hot},\mathrm{rain})+P(\mathrm{cold},\mathrm{rain})=0.1+0.3=0.4. \end{aligned} \]
4.5 条件概率、条件分布与归一化
对于事件 \(A,B\) 且 \(P(B)>0\):
\[ P(A\mid B)=\frac{P(A\cap B)}{P(B)}. \]
条件分布是对一个变量所有取值的条件概率集合。例如:
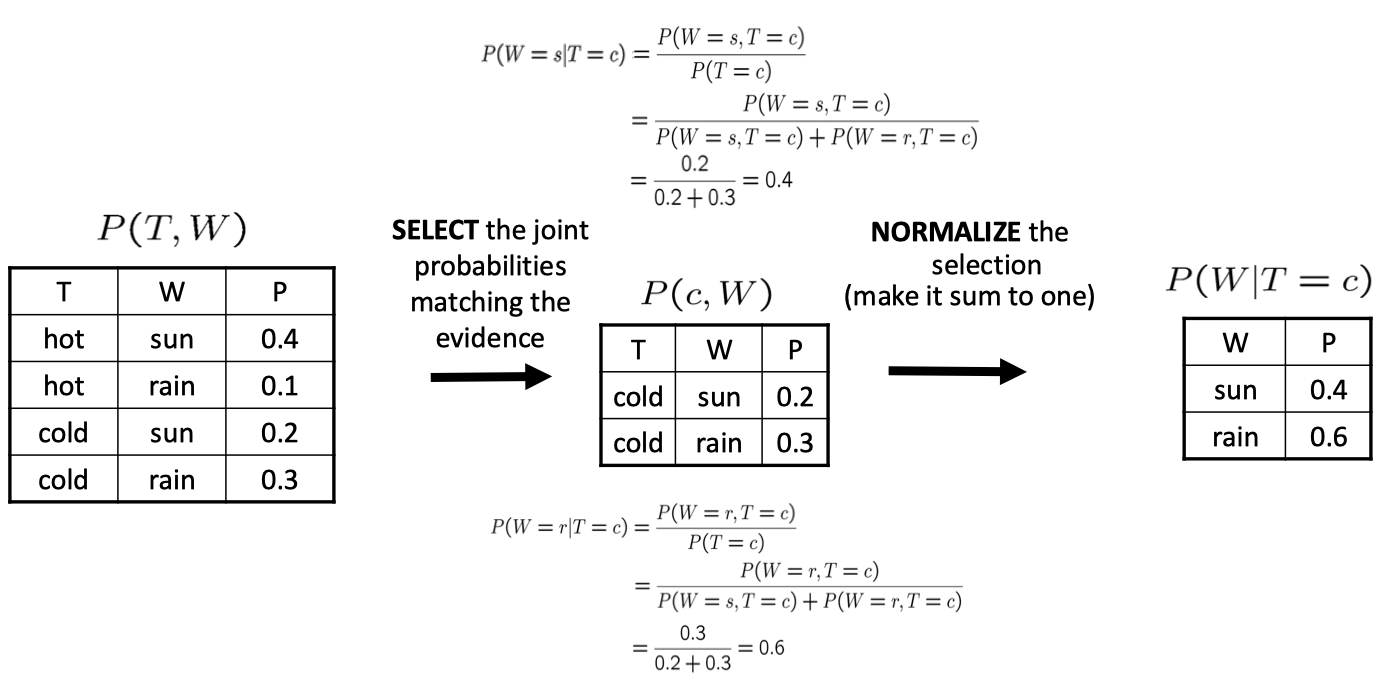
\[ P(W=\mathrm{sun}\mid T=\mathrm{cold}) =\frac{0.2}{0.2+0.3}=0.4, \]
\[ P(W=\mathrm{rain}\mid T=\mathrm{cold}) =\frac{0.3}{0.2+0.3}=0.6. \]
计算步骤是先筛选符合证据的联合概率条目,再归一化。一般地,给定非负权重 \(q_i\) 且 \(Z=\sum_iq_i>0\),令
\[ p_i=\frac{q_i}{Z},\qquad\sum_ip_i=1. \]
例如 \((0.2,0.3)\) 归一化为 \((0.4,0.6)\);\((20,5,10,15)\) 归一化为 \((0.4,0.1,0.2,0.3)\)。若 \(Z=0\),不能直接做除法;离散模型中零概率证据的条件分布也不能由上述比值定义。
条件分布的逐步计算
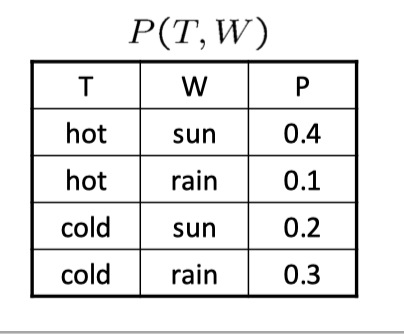
- 固定证据 \(T=\mathrm{cold}\),保留 \((\mathrm{cold},\mathrm{sun})\) 和 \((\mathrm{cold},\mathrm{rain})\) 两行,权重分别为 \(0.2,0.3\)。
- 求证据概率 \(Z=P(T=\mathrm{cold})=0.2+0.3=0.5\)。
- 分别除以 \(Z\):\(0.2/0.5=0.4\),\(0.3/0.5=0.6\)。
- 得到 \(P(W\mid T=\mathrm{cold})=(0.4,0.6)\),检查 \(0.4+0.6=1\)。
一般地,给定 \(X_2=x_2\),对 \(X_1\) 的条件分布为
\[ P(x_1\mid x_2)=\frac{P(x_1,x_2)}{P(x_2)},\qquad P(x_2)=\sum_{x_1}P(x_1,x_2). \]
其中分母是在固定 \(x_2\) 后,对 \(x_1\) 的所有可能取值求和。
两个归一化例题
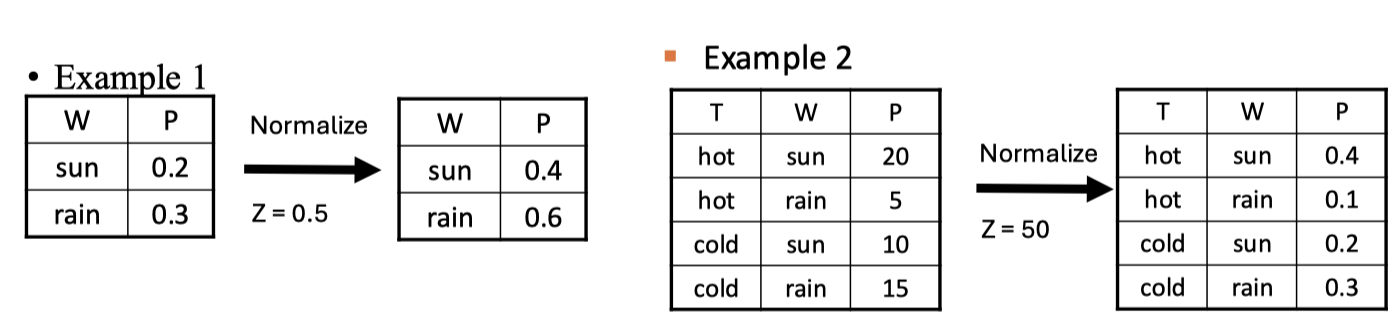
- 第一例:\(Z=0.2+0.3=0.5\),归一化后为 \((0.2/0.5,0.3/0.5)=(0.4,0.6)\)。
- 第二例:\(Z=20+5+10+15=50\),四个条目依次为 \(20/50=0.4\)、\(5/50=0.1\)、\(10/50=0.2\)、\(15/50=0.3\)。
Normalization 在不同领域可以泛指按指定标准调整数值。本节专指对非负概率权重作总和归一化,使结果相加为 \(1\)。
4.6 概率推断的基本公式
概率推断(probabilistic inference)指利用概率模型与已知证据,计算关心的概率。以下规则不要求变量相互独立。
乘法公式(Product Rule)
\[ P(x,y)=P(y)P(x\mid y)=P(x)P(y\mid x). \]
链式法则(Chain Rule)
\[ P(x_1,\ldots,x_n)=\prod_{i=1}^nP(x_i\mid x_1,\ldots,x_{i-1}). \]
第一个因子为 \(P(x_1)\);各条件概率用于其条件有正概率的情况。
贝叶斯公式(Bayes’ Rule)
\[ P(x\mid y)=\frac{P(y\mid x)P(x)}{P(y)},\qquad P(y)>0. \]
后验概率与“似然 × 先验”成正比,分母是证据概率,用于归一化。
全概率公式(Law of Total Probability)
若 \(B_1,\ldots,B_n\) 两两互斥且构成样本空间的划分,并且所用条件概率有定义,则
\[ P(A)=\sum_{i=1}^nP(A\mid B_i)P(B_i). \]
每个划分事件 \(B_i\) 对总概率的贡献为 \(P(A\mid B_i)P(B_i)\)。零概率划分项可直接按 \(P(A\cap B_i)=0\) 处理。
三个变量时,链式法则具体写为
\[ P(x_1,x_2,x_3)=P(x_1)P(x_2\mid x_1)P(x_3\mid x_1,x_2). \]
贝叶斯公式则把 \(P(y\mid x)\) 与先验 \(P(x)\) 结合,换算为观测 \(y\) 后的 \(P(x\mid y)\)。例如知道“某种天气下观测到某现象的概率”,可进一步推断“观测到该现象后各种天气的概率”,而不是直接交换条件两侧。
Lecture 5: Constraint Satisfaction Problems
5.1 从路径规划到约束满足
路径规划关心“如何到达目标”,路径本身及其代价是答案的一部分。约束满足问题(constraint satisfaction problem, CSP)主要关心“哪些变量赋值满足条件”,得到赋值的搜索路径通常不属于答案。
CSP 由三部分组成:
- 变量:\(X_1,\ldots,X_n\)。
- 取值域:每个变量 \(X_i\) 有取值域 \(D_i\),不同变量的域可以不同。
- 约束:规定某些变量组合允许哪些联合取值。
解是一个完整且满足全部约束的赋值。搜索过程中可使用部分赋值作为状态。一般搜索把状态当作黑箱,CSP 则显式暴露变量和约束,使算法能够进行通用推理与剪枝。
同一个机器人寻宝任务可产生两类问题:规划问题问“沿什么路径到达宝石”,路径的长度与代价很重要;识别式问题问“哪些位置或配置满足宝石所在条件”,答案主要是状态或赋值。在一步给一个变量赋值的完整 CSP 搜索中,完整赋值通常都在深度 \(n\),但取值是否合规仍需检查。
一般搜索的目标测试与后继函数可以是任意可计算规则;CSP 则以变量、域和约束构成明确的表示语言,便于使用统一的排序、过滤与结构分解算法。
5.2 地图着色与二元约束图
澳大利亚地图着色的变量为 WA、NT、Q、NSW、V、SA、T,每个域都是 \(\{\mathrm{red},\mathrm{green},\mathrm{blue}\}\)。每对相邻地区必须异色,例如
\[ WA\ne NT. \]
同一约束也可通过允许的值对显式表示:
\[ (WA,NT)\in\{(r,g),(r,b),(g,r),(g,b),(b,r),(b,g)\}. \]
这里 \(r,g,b\) 分别代表红、绿、蓝。一组合法解为:
WA=red, NT=green, Q=red, NSW=green,
V=red, SA=blue, T=green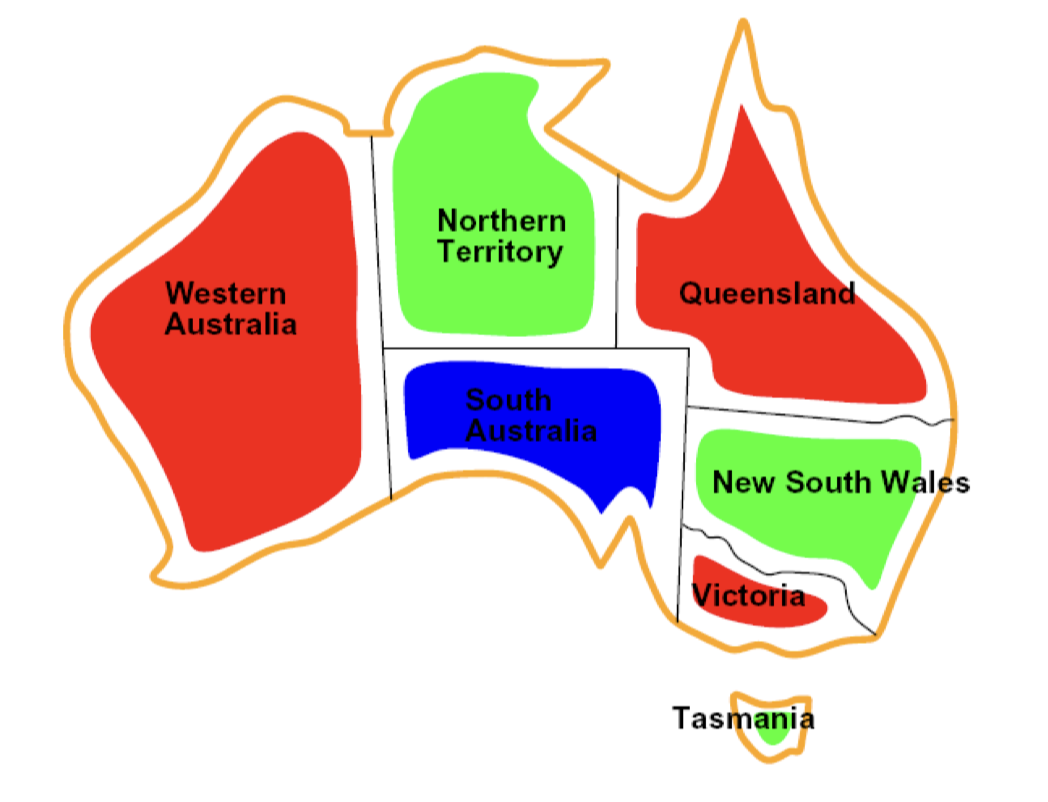
二元 CSP(binary CSP)的每个约束至多涉及两个变量。其约束图中,节点代表变量,边代表变量间约束;通常用无向边表示约束关系。运行弧一致性算法时,再把一条关系看作两个有向弧分别检查。
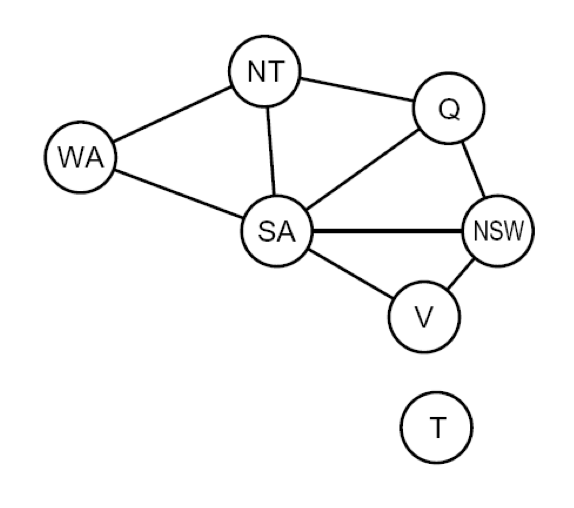
各区域缩写对应:WA(Western Australia,西澳大利亚)、NT(Northern Territory,北领地)、Q(Queensland,昆士兰)、NSW(New South Wales,新南威尔士)、V(Victoria,维多利亚)、SA(South Australia,南澳大利亚)、T(Tasmania,塔斯马尼亚)。每个区域都从 Red、Green、Blue 中选择一种颜色。
用关系式写出的 \(WA\ne NT\) 是内涵式(intensional)约束;列出全部允许颜色对的是外延式(extensional)约束。二者可以描述同一个合法赋值集合。
5.3 N 皇后问题的两种建模
目标是在 \(N\times N\) 棋盘上放置 \(N\) 个皇后,使任意两个皇后不同行、不同列、不同对角线。
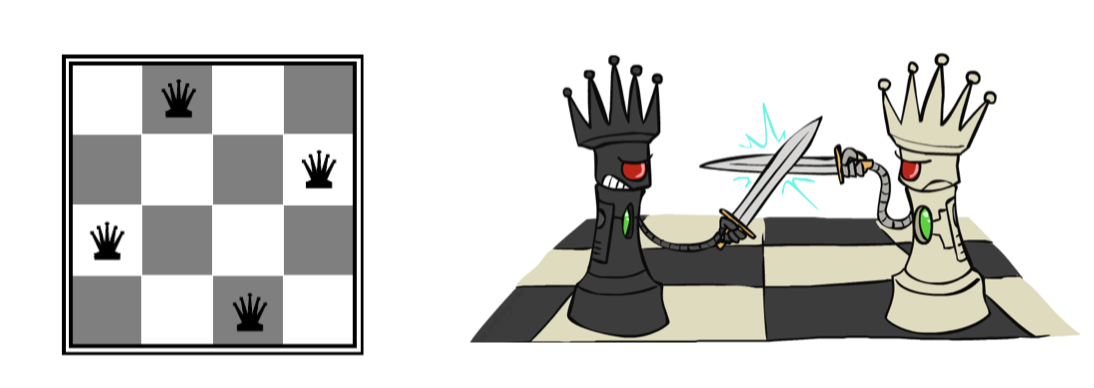
建模一:每格一个布尔变量
令 \(X_{ij}\in\{0,1\}\) 表示第 \(i\) 行、第 \(j\) 列是否放置皇后。可写成:
\[ \sum_{j=1}^NX_{ij}=1\quad(i=1,\ldots,N), \]
\[ \sum_{i=1}^NX_{ij}=1\quad(j=1,\ldots,N), \]
\[ X_{ij}+X_{k\ell}\leq1 \quad\text{当 }(i,j)\ne(k,\ell),\ |i-k|=|j-\ell|. \]
也可以用任意两个同行、同列或同对角线格子不能同时为 \(1\) 的二元约束,再加总数约束 \(\sum_{i,j}X_{ij}=N\)。只写“最多一个”而不限制总数,会错误地允许空棋盘。
建模二:每行一个列号变量
令 \(Q_i\in\{1,\ldots,N\}\) 表示第 \(i\) 行皇后的列号。每行恰有一个皇后已包含在变量定义中。对所有 \(i<j\):
\[ Q_i\ne Q_j,\qquad |Q_i-Q_j|\ne|i-j|. \]
第一式排除同列,第二式排除同对角线。显式枚举允许值对时,也必须同时满足这两个条件。
布尔棋盘模型的成对约束展开
令 \(\mathcal{R}=\{(0,0),(0,1),(1,0)\}\),即禁止两个位置同时取 \(1\)。所有下标都必须在棋盘内,且比较的是两个不同格子。
- 同行:对于固定行 \(i\) 和不同列 \(j,k\):
\[ (X_{ij},X_{ik})\in\mathcal{R}. \]
- 同列:对于固定列 \(j\) 和不同行 \(i,k\):
\[ (X_{ij},X_{kj})\in\mathcal{R}. \]
- 主对角线方向:对于 \(k\geq1\) 且两格均有效:
\[ (X_{ij},X_{i+k,j+k})\in\mathcal{R}. \]
- 副对角线方向:对于 \(k\geq1\) 且两格均有效:
\[ (X_{ij},X_{i+k,j-k})\in\mathcal{R}. \]
- 皇后总数:
\[ \sum_{i=1}^N\sum_{j=1}^NX_{ij}=N. \]
成对约束保证互不攻击,总数约束保证恰好放置 \(N\) 个皇后。在每行至多一个且总数为 \(N\) 的条件下,每行恰好一个。
每行一个列号的模型也可用允许值对描述,例如 \(N\geq4\) 时,\((Q_1,Q_2)=(1,3)\) 或 \((1,4)\) 满足不同列与不同对角线的要求。完整关系需要列出所有同时满足 \(Q_1\ne Q_2\)、\(|Q_1-Q_2|\ne1\) 的值对。
5.4 约束类型、变量类型与应用
| 约束类型 | 涉及变量数或含义 | 示例 |
|---|---|---|
| 一元约束 | 一个变量 | \(SA\ne\mathrm{green}\) |
| 二元约束 | 两个变量 | \(WA\ne NT\) |
| 高阶约束 | 三个及以上变量 | \(X_1+X_2+X_3=5\) |
| 全局约束 | 对一组变量表达共同结构 | \(\operatorname{AllDifferent}(Q_1,\ldots,Q_N)\) |
| 硬约束 | 必须满足 | 两门必修课不能时间冲突 |
| 软约束 | 希望满足或赋予违反成本 | 尽量避免早上第一节排课 |
全局约束可以使用专门传播器,不一定先拆成成对约束。例如 AllDifferent 与成对不等式在合法解集合上等价,但专用传播器可能推断得更多。一般高阶约束也不能保证仅用原变量上的二元约束等价替换;有时需要辅助变量。
- 有限离散域:若有 \(n\) 个变量、每个至多 \(d\) 个值,完整赋值数至多 \(d^n\)。
- 无限离散域:例如任务开始时间取非负整数。
- 连续域:例如开始时间、位置或控制量取实数;实数域不能归入“离散域”。
典型应用包括课程与教师分配、时间表、硬件兼容配置、交通排班和工厂调度。线性连续约束可用线性规划处理;含整数、非线性或逻辑约束的问题可能需要整数规划、非线性求解或约束编程等不同方法。
基础约束与高级约束的示例
AllDifferent(X1,...,X9)表示数独某一行九个变量两两不同;成对展开包含 \(X_1\ne X_2\)、\(X_1\ne X_3\),直到全部不同变量对。sum([X11,X12,...,XNN]) = N对应棋盘模型的皇后总数约束。- 调度任务的变量可以是开始时间 \(S_A,S_B,S_C\),也可以另设结束时间 \(E_A,E_B,E_C\);取非负整数时是无限离散域,取实数时是连续域。天文观测调度可用连续开始和结束时间描述哈勃望远镜观测窗口。
- 偏好约束可将红色的代价设得低于绿色。满足硬约束后,再最小化总偏好代价,得到约束优化问题。
真实应用的变量和约束
- 教师分配:若每个老师只分配一门课,可令变量为老师、域为课程;允许一位老师教多门课时,可改用“每门课的任课教师”为变量,或使用集合域等表示。
- 课程时间表:变量可以是课程的日期与时段,约束排除教师或学生必须参加的课程冲突。
- 硬件配置:选择主板、显卡、电源等,满足插槽、接口和功率兼容约束。
- 交通排班:为公交、火车、司机和车辆安排班次、轮换与休息。
- 工厂调度:决定产品在哪台机器、什么时间加工,并满足先后关系和资源容量。
连续问题是否可用 LP 求解取决于约束和目标是否线性;变量类型与约束结构决定具体求解方法。
5.5 回溯搜索(Backtracking Search)
回溯搜索是按变量逐步赋值的 DFS:每次选择一个未赋值变量,尝试一个值;若与已有赋值不一致,就换值;若所有值都失败,撤销上一步赋值并回溯。
赋值操作可交换:同一个完整赋值不需要因为赋值顺序不同而搜索 \(n!\) 次。因此可以固定变量顺序,也可以根据当前剩余问题动态选变量。
例如链状约束 \(A\ne B,B\ne C\),每个域为 \(\{r,g\}\):
{} → {A=r}
尝试 B=r:冲突,拒绝
尝试 B=g:得到 {A=r,B=g}
尝试 C=r:得到完整解 {A=r,B=g,C=r}
常用改进包括:
- MRV(minimum remaining values):优先选择当前剩余合法值最少的变量。
- 度启发式(degree heuristic):在需要时优先选择对其他未赋值变量约束较多者。
- LCV(least constraining value):先尝试对其余变量排除值较少的取值。
- 过滤与传播:尽早发现未来必然失败的分支。
- 结构分解:利用独立分量等结构。
回溯搜索的逐步赋值
- 从空赋值
{}开始,尚未固定任何变量。 - 选择 \(A\) 并尝试
Red,得到{A: Red}。 - 为 \(B\) 尝试
Red,由于 \(A\ne B\),立即拒绝该候选;这时改试 \(B\) 的下一个值,不必立刻撤销 \(A\)。 - 尝试 \(B=\mathrm{Green}\),得到一致的部分赋值
{A: Red, B: Green}。 - 令 \(C=\mathrm{Red}\),它与 \(B\) 不同;\(A,C\) 不相邻,无须异色。
- 三个变量均已赋值且全部约束满足,返回
{A: Red, B: Green, C: Red}。
每次赋值就检查已能判定的约束,称为增量式目标检查(incremental goal test)。若某变量所有值都失败,再撤销更早的选择,并恢复由该分支传播造成的域删减。
5.6 前向检查与约束传播
前向检查(forward checking)在变量赋值后,删除其未赋值邻居域中与该赋值冲突的值。任何域变为空,都可立即回溯。
例如 \(WA=r\),则从 NT 和 SA 的域中删除 \(r\)。但前向检查通常不会继续检查未赋值变量之间的相互约束,因此可能漏掉更远的冲突。
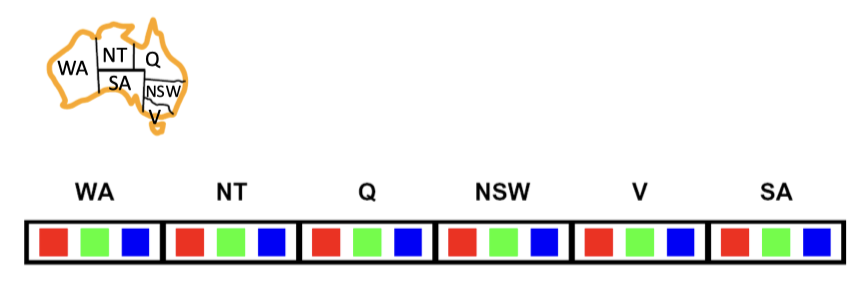
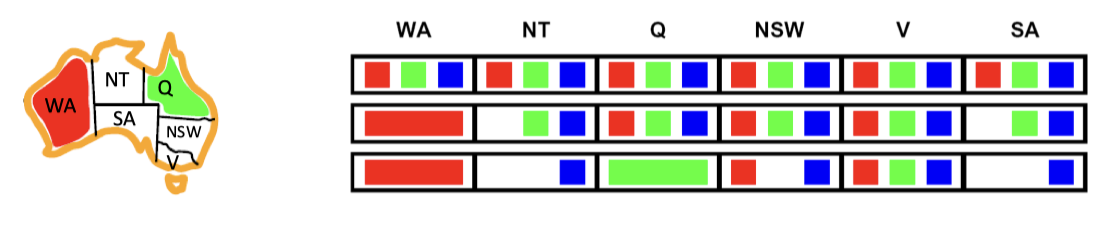
约束传播(constraint propagation)是更一般的推理:一个域缩小可能使其他域继续缩小,直到达到稳定状态或发现空域。弧一致性是二元约束中常用的一种局部一致性条件。
例如 \(D_{NT}=\{\mathrm{red},\mathrm{blue}\}\)、\(D_{SA}=\{\mathrm{blue}\}\),且 WA 与二者相邻、NT 与 SA 也相邻:先赋 \(WA=\mathrm{red}\),则 NT 的 red 被删除,迫使 \(NT=\mathrm{blue}\);进一步传播 \(NT\ne SA\),SA 的 blue 也被删除,形成空域。这时可以立即判定当前分支失败。只做从 WA 出发的一步前向检查,会暂时看不到 NT 与 SA 之间的冲突。
5.7 弧一致性(Arc Consistency)
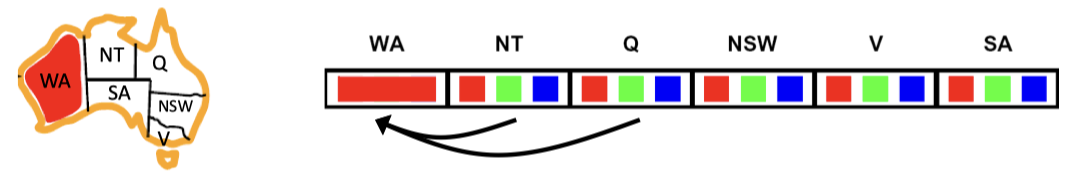
有向弧 \(X\to Y\) 一致,当且仅当对每个 \(x\in D_X\),至少存在一个 \(y\in D_Y\) 使二元约束 \(C_{XY}(x,y)\) 成立:
\[ \forall x\in D_X,\ \exists y\in D_Y:\ C_{XY}(x,y). \]
如果某个 \(x\) 没有这样的支持值,就从弧尾 \(X\) 的域中删除它。检查 \(X\to Y\) 不会直接修改 \(D_Y\)。
例如,约束 \(WA\ne NT\),\(D_{WA}=\{r\}\),\(D_{NT}=\{r,g,b\}\):
- 检查 \(WA\to NT\):\(WA=r\) 有 \(NT=g\) 或 \(b\) 支持,因此不删值。
- 检查 \(NT\to WA\):\(NT=r\) 没有支持,删除该值,留下 \(\{g,b\}\)。
两个方向的检查结果不同,不能只检查一边就宣布整个约束已弧一致。
5.8 AC-3 算法
AC-3 本身只传播约束,不会随机给变量赋值。初始可以检查全部有向弧;也可以在回溯搜索的一次赋值后,检查受影响的弧。
AC-3(domains, constraints):
    queue ← all directed constraint arcs
    while queue is not empty:
        (X, Y) ← queue.pop()
        if REVISE(X, Y):
            if D[X] is empty:
                return failure
            for Z in neighbors(X) excluding Y:
                queue.add((Z, X))
    return success

REVISE(X, Y):
    revised ← false
    for x in a copy of D[X]:
        if no y in D[Y] satisfies C[X,Y](x,y):
            delete x from D[X]
            revised ← true
    return revised
当 \(D_X\) 缩小时,原本靠 \(D_X\) 获得支持的邻居值可能失去支持,所以重新加入的是 \(Z\to X\)。队列顺序影响传播过程与效率,但“先处理哪个方向”不是固定的正确性要求。
链状示例:逐次列出队列与域
设 \(A-B-C\),约束为 \(A\ne B,B\ne C\)。最初三个域均为 \(\{r,g\}\),完整有向弧集合为
\[ Q_0=[A\to B,\ B\to A,\ B\to C,\ C\to B]. \]
对初始域运行 AC-3,不会删值:每个颜色都能在邻居中找到另一种颜色作为支持。接着,在回溯搜索中决定 \(A=r\),将 \(D_A\) 缩小为 \(\{r\}\),再进行传播。为便于跟踪,按以下顺序处理全部弧:
\[ Q=[B\to A,\ A\to B,\ C\to B,\ B\to C]. \]
- 取出 \(B\to A\)。检查 \(D_B=\{r,g\}\):\(B=r\) 找不到与 \(A=r\) 不同的支持值,删除;\(B=g\) 有 \(A=r\) 支持,保留。因此
\[ D_B=\{g\},\qquad Q=[A\to B,\ C\to B,\ B\to C]. \]
\(D_B\) 改变后,应确保 \(C\to B\) 在队列中;它已经在队列里,不必重复加入。
- 取出 \(A\to B\)。\(A=r\) 由 \(B=g\) 支持,无需删除:
\[ D_A=\{r\},\qquad Q=[C\to B,\ B\to C]. \]
- 取出 \(C\to B\)。\(C=r\) 与 \(B=g\) 不冲突,保留;\(C=g\) 找不到异色支持,删除:
\[ D_C=\{r\},\qquad Q=[B\to C]. \]
- 取出 \(B\to C\)。\(B=g\) 由 \(C=r\) 支持,域不变:
\[ D_B=\{g\},\qquad Q=[\,]. \]
- 队列为空,所有弧一致,最终为 \(A=r,B=g,C=r\)。本例的域都成为单元素域,所以也得到完整解。
如果采用其他队列顺序,可能先检查到暂时无须删值的弧;域随后变化时,相关弧要重新入队。正确性取决于持续处理受影响的弧,而不是固定先检查某个方向。
回溯时必须恢复当前分支删去的域值。把弧一致性维护嵌入回溯搜索,常称为 MAC(maintaining arc consistency)。
复杂度与局限
若有 \(e\) 条有向弧、最大域大小为 \(d\),标准 AC-3 最坏时间为 \(O(ed^3)\);稠密约束图中 \(e=O(n^2)\),因此也常写为 \(O(n^2d^3)\)。其他算法或额外支持记录可改善复杂度,不能把它们混为标准 AC-3 的同一结论。
采用支持记录与计数的其他弧一致性算法可达到 \(O(ed^2)\),稠密图中对应 \(O(n^2d^2)\);这是算法和数据结构的改进,而非标准 AC-3 的直接界。
弧一致不保证有解。例如三角形中三个变量都只有 \(\{r,g\}\),且每对变量都要求异色:每条弧都一致,但三角形不能用两种颜色合法着色。局部支持不等于所有约束能同时满足。
Lecture 6/7: Game Theory and Utilities
6.1 博弈类型与形式化
博弈可以按以下维度区分:
- 确定性或随机性:是否含骰子等随机结果。
- 玩家数量:单人、两人或多人。
- 零和或一般和:各玩家效用是否完全对立。
- 完美信息或不完美信息:行动时是否知道此前全部行动和相关状态。标准国际象棋是完美信息博弈;扑克有隐藏手牌,是不完美信息博弈。
一个确定性、轮流行动的博弈模型通常包含状态集合 \(S\)、玩家集合 \(P\)、当前行动玩家 \(\operatorname{Player}(s)\)、合法动作 \(A(s)\)、转移函数、终止测试和终局效用:
\[ \operatorname{Result}:S\times A\to S, \qquad U:S_{\mathrm{terminal}}\times P\to\mathbb{R}. \]
状态需包含轮到谁行动等决定后续所需的信息。策略(strategy/policy)规定在各种可能的决策情形下如何行动;本讲完全可观测的确定性策略可写为 \(s\mapsto a\)。随机策略则给出行动分布,不完美信息下应以玩家可区分的信息状态为依据。
两人零和博弈满足 \(U_1(s)=-U_2(s)\)。一般和博弈不要求效用相反,可以同时包含合作与竞争;不能直接假设每个对手都在最小化同一个玩家的效用。
博弈模型的逐项含义
- States:所有可能局面组成 \(S\),例如棋盘配置以及轮到谁行动。
- Players:\(P=\{1,2,\ldots,N\}\),轮流行动的游戏需指明当前玩家。
- Actions:由当前局面与玩家决定,例如 Pac-Man 的合法移动方向。
- Transition:确定性规则下,一个状态与一个合法动作唯一确定后继。
- Terminal test:\(\operatorname{Terminal}:S\to\{\mathrm{true},\mathrm{false}\}\),判断游戏是否结束。
- Terminal utilities:在终局给每个玩家一个实数收益。
例如两个机器人争夺同一颗宝石,若一方拿到记 \(+1\)、另一方记 \(-1\),且没有其他收益,就可建模为零和竞争。若两个机器人分别偏好不同颜色的宝石,它们可能各自获益,也可能共享资源产生竞争,需分别定义效用函数,属于一般和博弈。
6.2 单智能体树与 Minimax
单智能体确定性任务中,如果收益已全部计入终局效用,则
\[ V(s)=\begin{cases} U(s),&s\text{ 是终局},\\ \max_{s'\in\operatorname{Succ}(s)}V(s'),&\text{否则}. \end{cases} \]
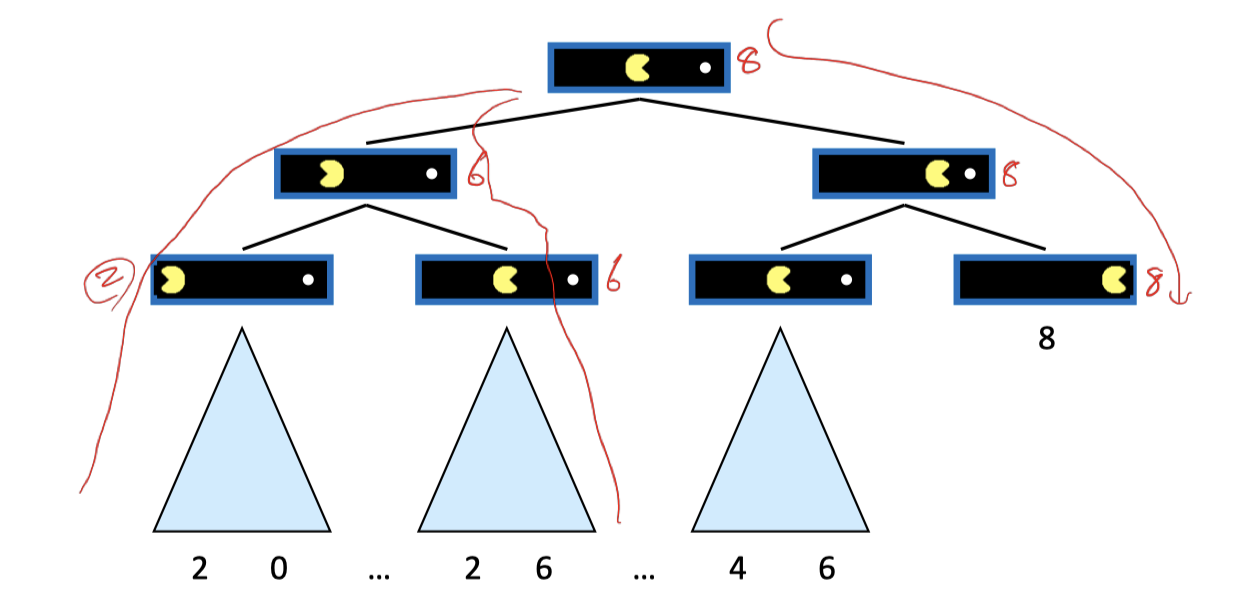
图中向上回传的计算可按子树逐一进行:
- 左下分支的已知叶子为 \(2,0\),父节点取 \(\max(2,0)=2\)。
- 另一分支的叶子为 \(2,6\),父节点取 \(\max(2,6)=6\)。
- 左侧更高一层取 \(\max(2,6)=6\)。
- 右侧一个分支的叶子为 \(4,6\),取 \(\max(4,6)=6\);与终局值 \(8\) 比较后取 \(\max(6,8)=8\)。
- 根节点比较两个孩子,取 \(\max(6,8)=8\)。
终局值直接来自游戏规则;非终局值由后继值递归计算。
两人、轮流行动、确定性、完美信息、零和博弈中,Minimax 的值统一从 MAX 的角度计分:
\[ V(s)=\begin{cases} U(s),&s\text{ 是终局},\\ \max_{s'\in\operatorname{Succ}(s)}V(s'),&s\text{ 轮到 MAX},\\ \min_{s'\in\operatorname{Succ}(s)}V(s'),&s\text{ 轮到 MIN}. \end{cases} \]
MAX 选对自己最有利的结果,MIN 选对 MAX 最不利的结果。这不是“假设对手犯错”,而是假设对手会进行最强反制。
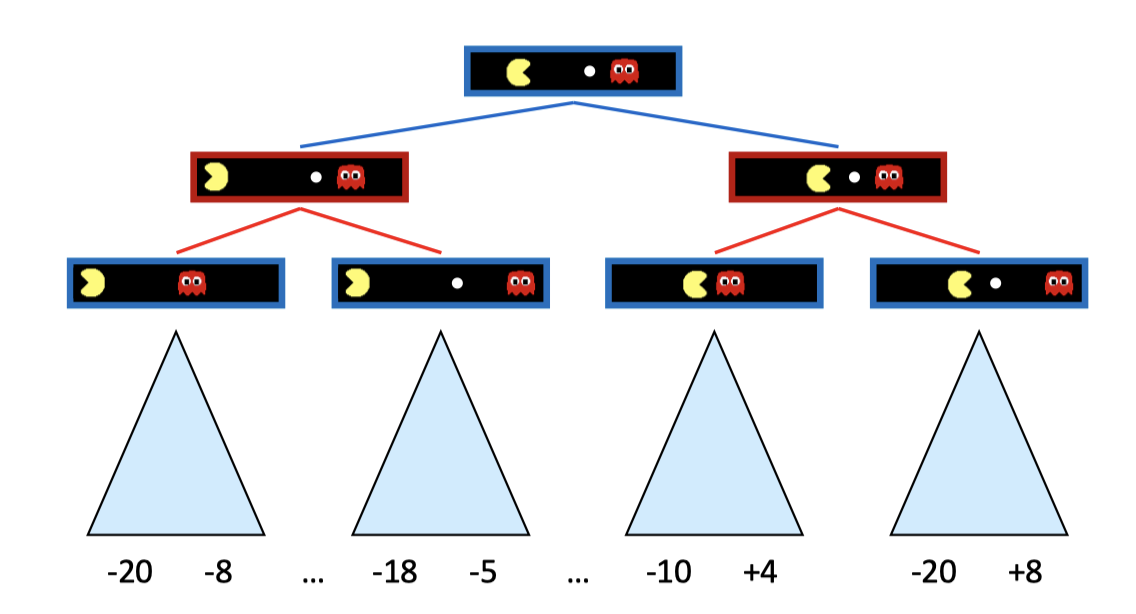
逐层计算时,先统一按 MAX 的得分视角给终局赋值:
- 四个底层 MAX 子树分别计算 \(\max(-20,-8)=-8\)、\(\max(-18,-5)=-5\)、\(\max(-10,4)=4\)、\(\max(-20,8)=8\)。
- 左侧 MIN 取 \(\min(-8,-5)=-8\),右侧 MIN 取 \(\min(4,8)=4\)。
- 根 MAX 取 \(\max(-8,4)=4\),选择右侧分支。
蓝色框对应 Pac-Man 决策,红色框对应对手决策。对手所选的最小值仍是 Pac-Man 的效用,而非换成另一套评分标准。
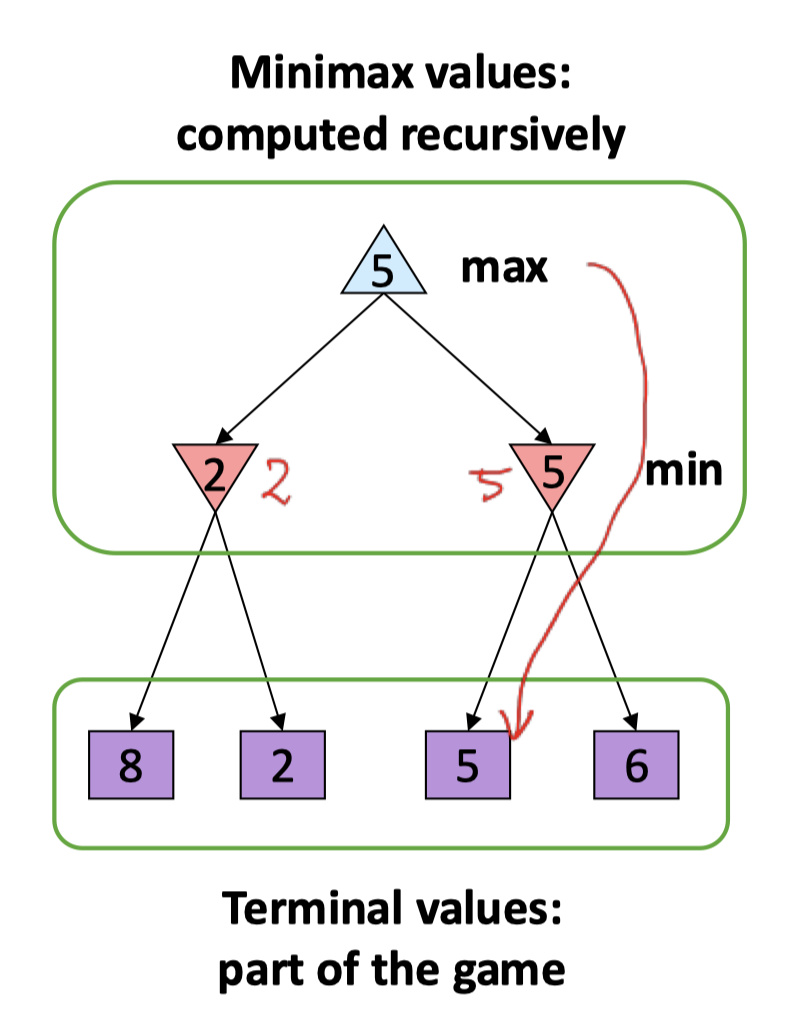
完整 Minimax 通常按 DFS 方式求值,时间为 \(O(b^m)\);显式保存兄弟节点的空间为 \(O(bm)\),逐个生成后继的递归实现可只用 \(O(m)\) 额外调用栈。这里 \(m\) 是行动层数。它给出最坏情况下的最优保障;若已知对手更弱或采用固定随机策略,针对该策略最大化期望收益可能获得更高平均得分。
6.3 深度受限搜索与评估函数
实际棋类的完整树太大,通常在深度限制处停止展开:真正终局使用 \(U(s)\),未结束的截断节点使用评估函数 \(\operatorname{Eval}(s)\)。例如
\[ \operatorname{Eval}(s)=\sum_jw_j\phi_j(s), \]
特征可包括棋子数量、位置优势、与目标距离或危险程度。
深度受限 Minimax 只对当前截断树给出最优选择,不保证真实博弈最优。更深搜索通常有帮助,但不能保证总能弥补错误评估。评估越复杂,单个叶节点成本越高,能搜索的深度也可能下降。
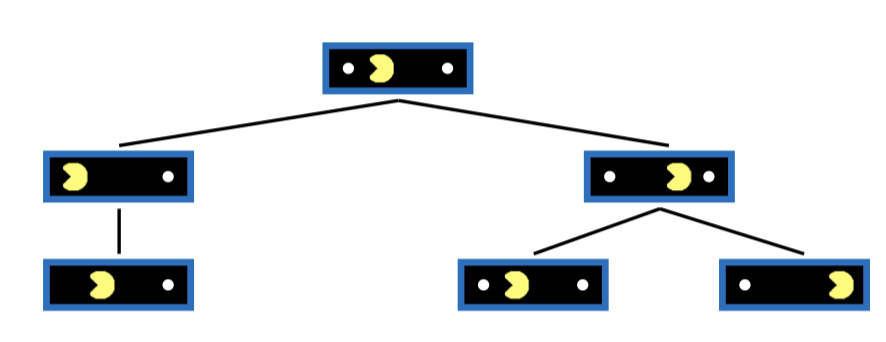
这个拖延例子可以分成四步理解:
- Pac-Man 看到立即吃掉豆子会得分。
- 若移动成本为零,并且短期评估只看最后分数,稍后回来吃可能得到相同分数。
- 立即吃掉后,深度限制(例如 \(2\) 层)内暂时没有更多得分机会;另一路径却把同样奖励放在视野末端。
- 若每次重规划都在平局时选择延后,可能反复推迟吃豆。加入距离、时间成本或一致的行动承诺,可以使“现在完成”与“不断拖延”得到不同评价。
这类问题可通过改进评估、考虑距离与每步成本、合适的平局策略或更长搜索来缓解。搜索截断也可能造成地平线效应(horizon effect):重要后果恰好落在视野之外。
6.4 α–β 剪枝(Alpha–Beta Pruning)
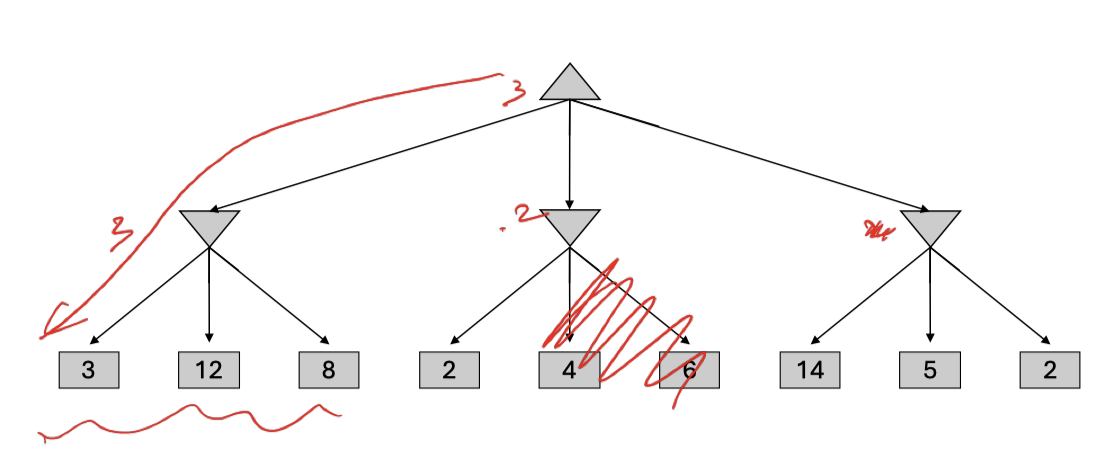
α–β 剪枝利用已有上下界,跳过不可能改变根节点 Minimax 结果的剩余分支:
- \(\alpha\):当前路径上 MAX 已有选择所提供的下界,初始为 \(-\infty\)。
- \(\beta\):当前路径上 MIN 已有选择所提供的上界,初始为 \(+\infty\)。
- MAX 节点更新 \(\alpha\leftarrow\max(\alpha,v)\);MIN 节点更新 \(\beta\leftarrow\min(\beta,v)\)。
- 当 \(\alpha\geq\beta\),该节点剩余未搜索的子树可以剪去。
剪枝由上下界和遍历次序决定。一个子树只要继承了祖先的有效界,就可能在搜索过程中触发剪枝;它在图中的左右位置本身不决定能否被剪去。
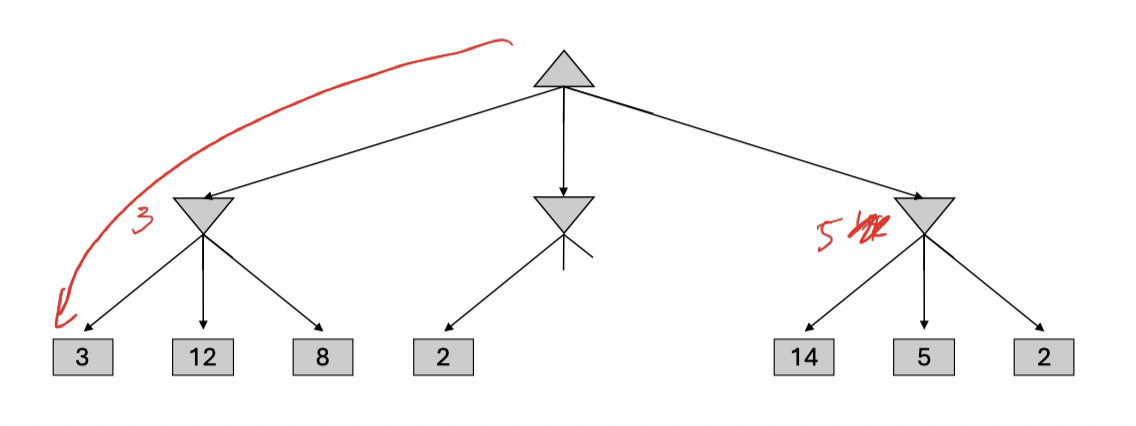
按从左到右顺序计算的完整例题
                      MAX1
                   /        \
                MIN2        MIN3
               /    \      /    \
            MAX4   MAX5   MAX6   MAX7
            /  \   /  \   /  \   /  \
5 6 7 10 2 3 0 9- MAX4 读取 \(5,6\),返回 \(6\);MIN2 的当前上界为 \(\beta=6\)。
- MAX5 继承 \(\beta=6\),读到第一个叶子 \(7\),已有 \(v\geq7\geq6\),可剪去 \(10\)。此时只需返回一个下界,无须求出 MAX5 的精确值 \(10\)。MIN2 仍可确定为 \(6\)。
- 根 MAX1 因而有 \(\alpha=6\)。
- 进入 MIN3,先求 MAX6,读取 \(2,3\) 后返回 \(3\)。
- MIN3 的当前上界降为 \(\beta=3\leq\alpha=6\),剪去整个 MAX7 子树,即 \(0,9\)。
- 根的值为 \(6\),与完整 Minimax 相同。
剪枝后的某些内部返回值只是界,不一定是精确 Minimax 值。若存在并列最优动作,具体选中哪个动作可能受遍历和平局规则影响。
最坏时间仍为 \(O(b^m)\);理想子节点排序下可接近 \(O(b^{m/2})\)。空间量级与 DFS 式 Minimax 相同。MAX 通常先搜索较好的高值动作,MIN 先搜索较好的低值动作,能更早建立有用的界。
用改变叶子值检查剪枝理由
在上面的八个叶子例题中,MAX4 的值已知为 \(6\):
- 若完整树中的 \(10\) 固定,把 MAX5 的第一个叶子 \(7\) 改成 \(0\) 或 \(100\),MAX5 分别为 \(10\) 或 \(100\),MIN2 都仍是 \(6\)。
- 若第一个叶子 \(7\) 已经被读到,把后一个叶子 \(10\) 改成 \(0\) 或 \(100\),MAX5 分别至少为 \(7\) 或 \(100\),MIN2 仍为 \(6\)。
- 但如果两个叶子同时都改为 \(0\),MIN2 会变为 \(0\)。因此,分别改变单个叶子的事后测试,不足以说明两个叶子都可以不看。
按从左到右的遍历,MAX5 尚未读到 \(7\) 时,也不知道后面的 \(10\)。读到 \(7\) 后才能利用 \(7\geq\beta=6\) 剪掉未访问的 \(10\)。
在 MIN3 分支,先算出 MAX6 的值为 \(3\) 后,已有 \(\min(3,V(\mathrm{MAX7}))\leq3\)。此时:
- 把 MAX7 的 \(0\) 改为 \(100\) 或 \(9\),MIN3 仍不超过 \(3\)。
- 把 MAX7 的 \(9\) 改为 \(100\) 或 \(0\),MIN3 也仍不超过 \(3\)。
- 根 MAX 已有另一路的 \(6\),因此 MAX7 无论取什么值都不能改善根的选择,可以整体剪去。
剪枝保留根节点的 Minimax 值,但被提前返回的内部节点可能只得到一个上界或下界。
6.5 Expectimax 与期望效用
若对手遵循某个已知概率策略,或环境包含随机事件,可使用机会节点(chance node)。其值不是最小值,而是概率加权平均:
\[ V(s)=\begin{cases} U(s),&s\text{ 是终局},\\ \max_{s'\in\operatorname{Succ}(s)}V(s'),&s\text{ 是 MAX 节点},\\ \sum_{s'}P(s'\mid s)V(s'),&s\text{ 是机会节点}. \end{cases} \]
概率需要与实际模型相符且总和为 \(1\);只有等概率时才能直接取算术平均。
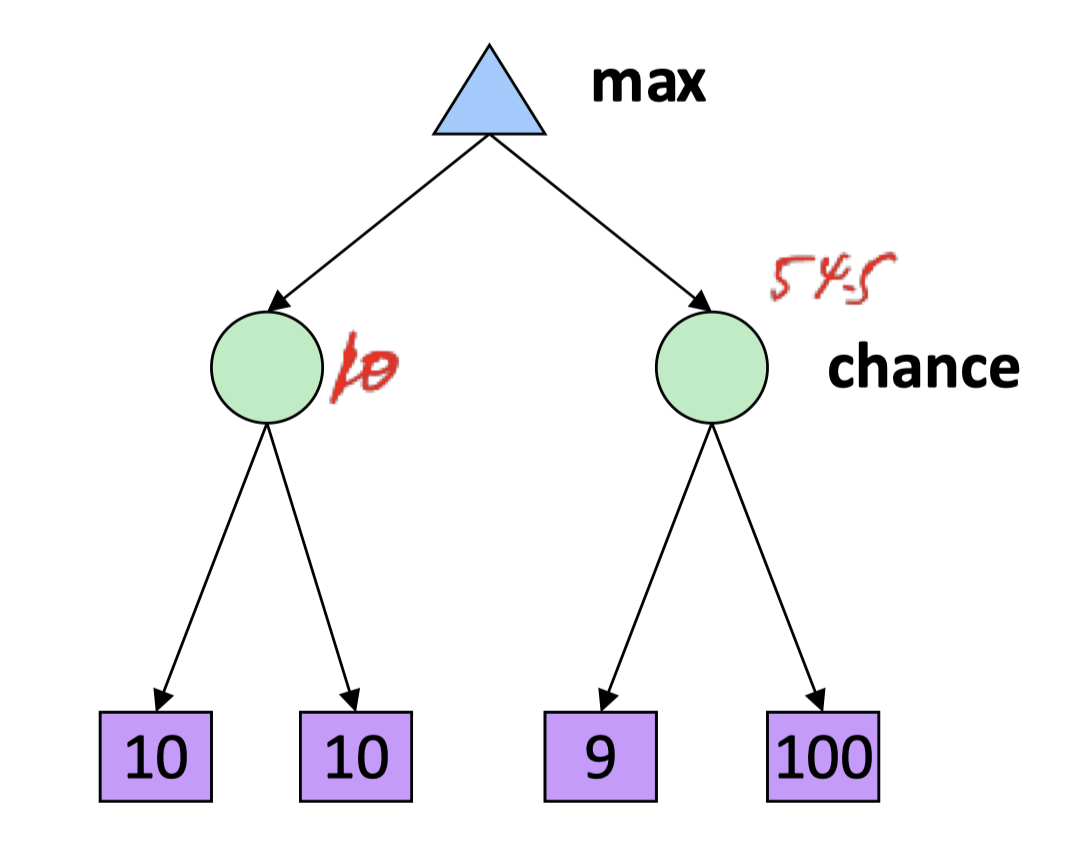
- 剪枝:若叶子值没有已知界,普通 α–β 规则不能直接用于机会节点,因为未访问的极端值可能大幅改变期望;若已知上下界,可利用剩余概率质量给出期望界并进行专门剪枝。
- 深度受限 Expectimax:截断处用评估值,再按最大值或期望值向上传播。
- 效用尺度:期望比较依赖数值间距。正仿射变换 \(U'=aU+b\)(\(a>0\))保留选择,一般的非线性单调变换可能改变选择;这与仅做大小比较的 Minimax 不同。
- 混合模型:有的博弈同时含 MAX、MIN 与机会节点,应按各节点实际含义求值。
例如幽灵可能按照固定随机规则行动,而不是每次都选使 Pac-Man 得分最低的动作;骰子也产生带概率的结果。此时用相应概率计算机会节点期望,比直接把它视为最强敌人更符合所建模型。
Lecture 8: Markov Decision Processes
8.1 马尔可夫性质(Markov Property)
在决策过程的状态表示充分时,给定当前状态和当前行动,下一状态的分布不再依赖更早的状态与行动历史:
\[ \begin{aligned} &P(S_{t+1}=s'\mid S_0,A_0,\ldots,S_t=s,A_t=a)\\ &\qquad=P(S_{t+1}=s'\mid S_t=s,A_t=a). \end{aligned} \]
“无记忆”指模型所需的历史信息已经包含在当前状态中,并不是智能体不能使用记忆。如果位置不足以预测下一步,还依赖速度或电量,就应把它们纳入状态。该式针对环境转移;未来行为还可能取决于所采用的策略。
8.2 MDP 的组成与策略
一个折扣 MDP 包含状态集合 \(S\)、可用行动 \(A(s)\)、转移概率 \(T\)、奖励 \(R\)、折扣因子 \(\gamma\),以及任务所需的初始状态或初始分布:
\[ T(s,a,s')=P(S_{t+1}=s'\mid S_t=s,A_t=a), \qquad \sum_{s'}T(s,a,s')=1. \]
本讲用 \(R(s,a,s')\) 表示该次转移的即时奖励;若奖励也是随机的,可在 Bellman 公式中使用它的条件期望。通常假设状态完全可观测、转移和奖励模型已知;模型未知时,相关学习问题属于强化学习范畴。
- 状态节点 \(s\):选择行动。
- 状态—行动节点(Q-state)\((s,a)\):行动已经选定,但随机后继尚未实现。
- 转移 \((s,a,s')\):从 \(s\) 执行 \(a\),以概率 \(T(s,a,s')\) 到达 \(s'\),获得奖励。
- 确定性平稳策略 \(\pi(s)\):只依赖当前状态,不随时间改变;随机策略写为 \(\pi(a\mid s)\)。
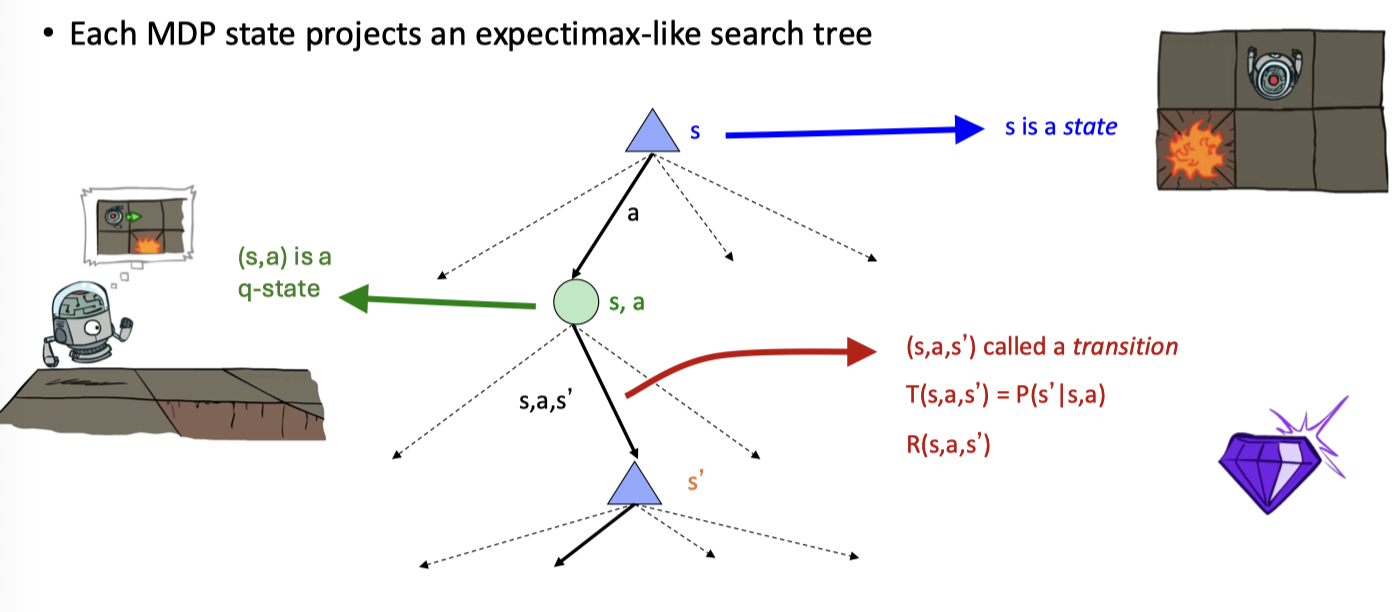
有限时域的最优策略通常还依赖剩余步数,可以写为 \(\pi_t(s)\);不能在所有 MDP 中一概假设最优策略都平稳。
8.3 回报与折扣(Discounting)
从时刻 \(t\) 开始的折扣回报定义为
\[ G_t=\sum_{k=0}^{\infty}\gamma^kR_{t+k+1},\qquad0\leq\gamma<1. \]
执行当前行动后得到的第一笔奖励乘 \(\gamma^0=1\),下一笔乘 \(\gamma\)。折扣可以表达时间偏好,也使有界奖励的无限和绝对收敛:若 \(|R_t|\leq R_{\max}\),则
\[ |G_t|\leq\frac{R_{\max}}{1-\gamma}. \]
例如 \(\gamma=0.5\):
\[ U([1,2,3])=1+0.5\times2+0.25\times3=2.75, \]
\[ U([3,2,1])=3+0.5\times2+0.25\times1=4.25. \]
无折扣的加性回报是各奖励直接相加。在有限时域或满足适当终止条件的任务中,也可以使用 \(\gamma=1\);不能把所有无折扣问题都视为不合法。
平稳偏好(stationary preferences)要求:若偏好奖励序列 \(A\) 胜于 \(B\),在两者前面加上相同奖励 \(r\) 后仍保持该偏好。固定正折扣下,\(U([r,A])=r+\gamma U(A)\),因此满足这一性质;\(\gamma=0\) 时未来奖励全部被忽略,严格偏好不一定保留。仅凭这一性质,不能无条件推导出唯一效用形式。
处理无限时域还可以使用有限截断,或保证任务在适当条件下终止。仅加入一个吸收态(absorbing state)并不足以保证回报有限:还需要关心是否会到达、需要多久,以及吸收后是否继续发奖。
奖励序列效用的两种写法
将从现在开始的奖励依次记为 \(r_0,r_1,r_2,\ldots\),则
\[ U_{\mathrm{add}}([r_0,r_1,r_2,\ldots])=r_0+r_1+r_2+\cdots, \]
\[ U_{\mathrm{disc}}([r_0,r_1,r_2,\ldots])=r_0+\gamma r_1+\gamma^2r_2+\cdots. \]
这里 \(r_0\) 是从当前决策开始得到的第一笔奖励,与回报公式中的 \(R_{t+1}\) 对应。固定 \(0<\gamma\leq1\) 且效用有定义时,平稳偏好可以写为
\[ A\succ B\quad\Longleftrightarrow\quad[r,A]\succ[r,B], \]
因为添加相同前缀后,两个序列的效用差由 \(U(A)-U(B)\) 变成 \(\gamma[U(A)-U(B)]\),符号不变。
对可能无限行动的任务,常见处理方式分别是:只计 \(T\) 步的有限时域;使用折扣使有界奖励和收敛;或设置到达后停止计奖的终点。三者是不同的任务设定,应先明确采用哪一种。
8.4 价值函数与 Bellman 方程
给定策略 \(\pi\):
\[ V^\pi(s)=\mathbb{E}_\pi[G_t\mid S_t=s], \]
\[ Q^\pi(s,a)=\mathbb{E}_\pi[G_t\mid S_t=s,A_t=a]. \]
\(V^\pi\) 是按策略行动的期望回报;\(Q^\pi\) 固定第一步行动,之后遵循策略。最优价值为 \(V^*(s)=\max_\pi V^\pi(s)\)。在有限、折扣、奖励有界的标准情形中,存在确定性平稳最优策略。
Bellman 最优性方程为
\[ Q^*(s,a)=\sum_{s'}T(s,a,s')\bigl[R(s,a,s')+\gamma V^*(s')\bigr], \]
\[ V^*(s)=\max_{a\in A(s)}Q^*(s,a), \]
\[ V^*(s)=\max_{a\in A(s)}\sum_{s'}T(s,a,s') \bigl[R(s,a,s')+\gamma V^*(s')\bigr]. \]
它把“当前即时奖励”与“后继状态的折扣价值”结合,再对随机结果取期望,对可选行动取最大值。
两状态自循环示例
只有一个可选动作 \(a\),从 \(s_1\) 出发:以 \(0.8\) 概率到 \(s_2\) 并奖励 \(5\),以 \(0.2\) 概率留在 \(s_1\) 并奖励 \(1\)。令 \(\gamma=0.9\);在 \(s_2\) 每步自循环奖励 \(1\),因此 \(V^*(s_2)=1/(1-0.9)=10\)。
\[ \begin{aligned} V^*(s_1)=Q^*(s_1,a) &=0.2[1+0.9V^*(s_1)]\\ &\quad+0.8[5+0.9\times10]\\ &=11.4+0.18V^*(s_1). \end{aligned} \]
故 \(V^*(s_1)=11.4/0.82\approx13.90244\)。这里 \(s_2\) 是持续发奖的吸收态,不是后续回报为零的终止态。
8.5 三状态 MDP 例题
考虑链状布局 \(s_1-s_2-s_3\),动作结果带随机性:
- State set:\(S=\{s_1,s_2,s_3\}\)。
- Actions:非终止状态可选择 \(L\)(Left)或 \(R\)(Right)。
- Discount:\(\gamma=0.9\)。
- 终局效用:\(s_3\) 为终点,到达后任务结束,规定终局边界值 \(V(s_3)=1\);移动过程的即时奖励为 \(0\)。
- 初始化:非终止状态 \(V_0(s_1)=V_0(s_2)=0\),终点在每一轮固定为 \(V_k(s_3)=1\)。
- 转移规律:
| 当前状态 | 行动 | 后继及概率 |
|---|---|---|
| \(s_1\) | \(R\) | \(s_2:0.8\),\(s_1:0.2\) |
| \(s_1\) | \(L\) | \(s_1:1.0\) |
| \(s_2\) | \(R\) | \(s_3:0.9\),\(s_1:0.1\) |
| \(s_2\) | \(L\) | \(s_1:0.9\),\(s_3:0.1\) |
这里使用终局效用边界:若经过 \(\tau\) 次转移到达 \(s_3\),终局效用对起点的贡献为 \(\gamma^\tau\)。它不是“进入终点的转移获得即时奖励 \(1\),之后价值为零”的计奖方式;二者的折扣位置相差一步。对终点不再做 Bellman 更新,也不继续重复领取效用。
带终局效用 \(U\) 的回报可明确写成
\[ G=\sum_{t=0}^{\tau-1}\gamma^t r_t+\gamma^\tau U(S_\tau). \]
本例各移动奖励 \(r_t=0\)、\(U(s_3)=1\),所以到达终点时剩余价值为 \(1\),此前每次转移都会将这一价值再折扣一次。
8.6 价值迭代(Value Iteration)
对非终止状态执行同步更新:
\[ V_{k+1}(s)=\max_a\sum_{s'}T(s,a,s') \bigl[R(s,a,s')+\gamma V_k(s')\bigr], \]
并固定终点 \(V_k(s_3)=1\)。同一轮右侧都使用上一轮 \(V_k\),而不是把刚更新的另一个状态值立刻代入。有限折扣问题的 Bellman 更新具有压缩性质,收敛到满足终局边界的唯一最优价值。
第 0 轮:初始化
\[ V_0(s_1)=0,\qquad V_0(s_2)=0,\qquad V_0(s_3)=1. \]
第 1 轮:分别尝试每个状态的两个动作
状态 \(s_2\),动作 Right:
\[ \begin{aligned} Q_0(s_2,R) &=0.9[0+0.9V_0(s_3)]+0.1[0+0.9V_0(s_1)]\\ &=0.9\times0.9\times1+0.1\times0.9\times0\\ &=0.81. \end{aligned} \]
状态 \(s_2\),动作 Left:
\[ \begin{aligned} Q_0(s_2,L) &=0.9[0+0.9V_0(s_1)]+0.1[0+0.9V_0(s_3)]\\ &=0.9\times0.9\times0+0.1\times0.9\times1\\ &=0.09. \end{aligned} \]
所以
\[ V_1(s_2)=\max(0.81,0.09)=0.81. \]
状态 \(s_1\),动作 Right:
\[ \begin{aligned} Q_0(s_1,R) &=0.8[0+0.9V_0(s_2)]+0.2[0+0.9V_0(s_1)]\\ &=0.8\times0.9\times0+0.2\times0.9\times0=0. \end{aligned} \]
状态 \(s_1\),动作 Left:
\[ Q_0(s_1,L)=1.0[0+0.9V_0(s_1)]=0. \]
所以 \(V_1(s_1)=\max(0,0)=0\),终点仍为 \(V_1(s_3)=1\)。
第 2 轮:继续逐项更新
状态 \(s_1\),动作 Right:
\[ \begin{aligned} Q_1(s_1,R) &=0.8[0+0.9V_1(s_2)]+0.2[0+0.9V_1(s_1)]\\ &=0.8\times0.9\times0.81+0.2\times0.9\times0\\ &=0.8\times0.729=0.5832. \end{aligned} \]
状态 \(s_1\),动作 Left:
\[ Q_1(s_1,L)=1.0[0+0.9V_1(s_1)]=0. \]
因此
\[ V_2(s_1)=\max(0.5832,0)=0.5832. \]
状态 \(s_2\),动作 Right:
\[ \begin{aligned} Q_1(s_2,R) &=0.9[0+0.9V_1(s_3)]+0.1[0+0.9V_1(s_1)]\\ &=0.9\times0.9\times1+0.1\times0.9\times0=0.81. \end{aligned} \]
状态 \(s_2\),动作 Left:
\[ \begin{aligned} Q_1(s_2,L) &=0.9[0+0.9V_1(s_1)]+0.1[0+0.9V_1(s_3)]\\ &=0.9\times0.9\times0+0.1\times0.9\times1=0.09. \end{aligned} \]
因此 \(V_2(s_2)=\max(0.81,0.09)=0.81\),终点仍为 \(V_2(s_3)=1\)。
| 轮数 \(k\) | \(V_k(s_1)\) | \(V_k(s_2)\) | \(V_k(s_3)\) |
|---|---|---|---|
| 0 | 0 | 0 | 1 |
| 1 | 0 | 0.81 | 1 |
| 2 | 0.5832 | 0.81 | 1 |
| 3 | 0.688176 | 0.862488 | 1 |
| 收敛值 | 0.77224576 | 0.87950212 | 1 |
每轮计算量
一般稠密模型需要依次遍历 \(|S|\) 个状态、每个状态的 \(|A|\) 个动作,以及每个动作至多 \(|S|\) 个后继,因此一轮为 \(O(|S|^2|A|)\)。对三个状态、两个动作,完整三层循环的组合数上界是 \(3\times2\times3=18\);实际可跳过终点更新以及零概率后继,减少运算。
提取策略与停止条件
从当前值 \(V_k\) 提取策略:
\[ \pi_k(s)\in\arg\max_a\sum_{s'}T(s,a,s') \bigl[R(s,a,s')+\gamma V_k(s')\bigr]. \]
前两轮已计算的非平局动作比较都偏好 Right;在 \(s_1\) 的第 1 轮则是平局。继续迭代或用策略评估与改进验证后,可得到最优策略
\[ \pi^*(s_1)=R,\qquad\pi^*(s_2)=R. \]
其意图是从 \(s_1\) 向右到 \(s_2\)、再向右到 \(s_3\);但由于转移随机,实际可能停留在 \(s_1\) 或从 \(s_2\) 返回 \(s_1\),所以解是策略表,而不是保证每次都执行成功的固定轨迹。
价值函数一般渐近收敛。实际实现可以用相邻迭代差、Bellman 残差阈值或最大轮数停止;停止后的策略是否满足目标精度,应结合相应误差条件判断。
8.7 策略评估与策略改进(Policy Iteration)
第一步:选择初始策略
继续使用 \(s_1-s_2-s_3\) 模型、表中的四条动作转移、\(\gamma=0.9\)、移动即时奖励 \(0\) 和终局值 \(V(s_3)=1\)。任意选取一个初始确定性策略:
\[ \pi_0(s_1)=R,\qquad\pi_0(s_2)=R. \]
\(s_3\) 已终止,无须选择动作。“任意选择初始策略”不等于执行时每次随机选动作;这里评估的是固定的 Right 策略。
第二步:为每个状态写策略评估方程
固定策略后,不再对动作取最大值:
\[ V^{\pi_0}(s)=\sum_{s'}T(s,\pi_0(s),s') \bigl[R(s,\pi_0(s),s')+\gamma V^{\pi_0}(s')\bigr]. \]
记 \(v_i=V^{\pi_0}(s_i)\)。在 \(s_1\),以 \(0.8\) 到 \(s_2\),以 \(0.2\) 留在 \(s_1\):
\[ \begin{aligned} v_1&=0.8[0+0.9v_2]+0.2[0+0.9v_1]\\ &=0.72v_2+0.18v_1. \end{aligned} \]
移项得到
\[ 0.82v_1=0.72v_2,\qquad v_1=\frac{0.72}{0.82}v_2\approx0.87804878v_2. \]
在 \(s_2\),以 \(0.9\) 到 \(s_3\),以 \(0.1\) 回到 \(s_1\):
\[ \begin{aligned} v_2&=0.9[0+0.9v_3]+0.1[0+0.9v_1]\\ &=0.81+0.09v_1, \end{aligned} \]
其中 \(v_3=1\)。
第三步:联立求解
把第二个方程代入 \(0.82v_1=0.72v_2\):
\[ \begin{aligned} 0.82v_1&=0.72(0.81+0.09v_1)\\ &=0.5832+0.0648v_1,\\ (0.82-0.0648)v_1&=0.5832,\\ 0.7552v_1&=0.5832. \end{aligned} \]
因此
\[ v_1=\frac{0.5832}{0.7552}\approx0.77224576, \]
\[ v_2=0.81+0.09\times0.77224576\approx0.87950212, \qquad v_3=1. \]
也可以从非终止状态全零的初始值出发,固定策略反复更新至收敛;若策略是随机的,评估方程还要按 \(\pi(a\mid s)\) 对行动求期望。
第四步:在 \(s_1\) 比较两个动作
Right 的值:
\[ \begin{aligned} Q^{\pi_0}(s_1,R) &=0.8[0+0.9v_2]+0.2[0+0.9v_1]\\ &=0.72\times0.87950212+0.18\times0.77224576\\ &\approx0.77224576. \end{aligned} \]
Left 的值:
\[ \begin{aligned} Q^{\pi_0}(s_1,L) &=1.0[0+0.9v_1]\\ &=0.9\times0.77224576\approx0.69502119. \end{aligned} \]
因为 \(0.77224576>0.69502119\),改进后在 \(s_1\) 保持 Right。
第五步:在 \(s_2\) 比较两个动作
Right 的值:
\[ \begin{aligned} Q^{\pi_0}(s_2,R) &=0.9[0+0.9v_3]+0.1[0+0.9v_1]\\ &=0.81+0.09\times0.77224576\\ &\approx0.87950212. \end{aligned} \]
Left 的值:
\[ \begin{aligned} Q^{\pi_0}(s_2,L) &=0.9[0+0.9v_1]+0.1[0+0.9v_3]\\ &=0.81\times0.77224576+0.09\\ &\approx0.71551907. \end{aligned} \]
因为 \(0.87950212>0.71551907\),改进后在 \(s_2\) 也保持 Right。
| 状态 | \(Q^{\pi_0}(s,R)\) | \(Q^{\pi_0}(s,L)\) | 改进后动作 |
|---|---|---|---|
| \(s_1\) | 0.77224576 | 0.69502119 | \(R\) |
| \(s_2\) | 0.87950212 | 0.71551907 | \(R\) |
第六步:检查策略是否稳定
一般更新式为
\[ \pi_{i+1}(s)\in\arg\max_a\sum_{s'}T(s,a,s') \bigl[R(s,a,s')+\gamma V^{\pi_i}(s')\bigr]. \]
重复“评估当前策略 → 贪心改进”。有限折扣问题中,精确评估且采用一致的平局处理时,策略稳定即可确定最优。本例两个非终止状态都没有改变,因此 \(\pi_0\) 已是最优策略。
对照:把奖励记在进入终点的转移上
另一种常见建模方式将首次进入 \(s_3\) 的即时奖励记为 \(+1\),其他转移奖励为 \(0\),并规定任务结束后的价值 \(\widehat V(s_3)=0\)。状态、行动与转移概率不变,只改变奖励发生的时刻。
从全零初始化,逐轮值为:
| 轮数 \(k\) | \(\widehat V_k(s_1)\) | \(\widehat V_k(s_2)\) | \(\widehat V_k(s_3)\) |
|---|---|---|---|
| 0 | 0 | 0 | 0 |
| 1 | 0 | 0.9 | 0 |
| 2 | 0.648 | 0.9 | 0 |
| 3 | 0.76464 | 0.95832 | 0 |
| 收敛值 | 0.85805085 | 0.97722458 | 0 |
第一轮在 \(s_2\):
\[ \widehat Q_0(s_2,R)=0.9[1+0.9\times0]+0.1[0+0.9\times0]=0.9, \]
\[ \widehat Q_0(s_2,L)=0.9[0+0.9\times0]+0.1[1+0.9\times0]=0.1. \]
因此 \(\widehat V_1(s_2)=0.9\);\(s_1\) 两动作值都为 \(0\),故 \(\widehat V_1(s_1)=0\)。第二轮有
\[ \widehat Q_1(s_1,R)=0.8[0+0.9\times0.9]+0.2[0+0.9\times0]=0.648, \]
\[ \widehat Q_1(s_1,L)=0,\qquad \widehat V_2(s_1)=0.648,\quad\widehat V_2(s_2)=0.9. \]
对固定 Right 策略,评估方程变为
\[ \widehat v_1=0.72\widehat v_2+0.18\widehat v_1,\qquad \widehat v_2=0.9+0.09\widehat v_1. \]
所以 \(0.7552\widehat v_1=0.648\),得到
\[ \widehat v_1\approx0.85805085,\qquad\widehat v_2\approx0.97722458. \]
四个动作值分别为
\[ \begin{aligned} \widehat Q(s_1,R)&=0.72\widehat v_2+0.18\widehat v_1\approx0.85805085,\\ \widehat Q(s_1,L)&=0.9\widehat v_1\approx0.77224576,\\ \widehat Q(s_2,R)&=0.9+0.09\widehat v_1\approx0.97722458,\\ \widehat Q(s_2,L)&=0.81\widehat v_1+0.1\approx0.79502119. \end{aligned} \]
仍然在两个非终止状态选择 Right。这里的到达奖励比终局边界效用少折扣一步,因此本例非终止状态的数值满足 \(V(s)=\gamma\widehat V(s)\)。两种约定都可使用,但转移奖励与终点边界值必须配套。
Lecture 9: Bayes’ Nets
9.1 概率模型与独立性
概率模型是对所关注世界部分的简化,可以用于解释、预测和信息价值分析。模型是否有用取决于它对任务中相关规律的刻画,而不是是否包含所有现实细节。
变量 \(X,Y\) 相互独立,记为 \(X\perp Y\),当且仅当
\[ P(x,y)=P(x)P(y)\quad\text{对所有 }x,y\text{ 成立}. \]
等价地,当 \(P(y)>0\) 时有 \(P(x\mid y)=P(x)\)。不能对零概率条件直接使用比值式。
例如 \(P(T=\mathrm{hot})=P(T=\mathrm{cold})=0.5\),\(P(W=\mathrm{sun})=0.6\)、\(P(W=\mathrm{rain})=0.4\)。如果假设 \(T\perp W\),联合表必须为:
| \(T\) | \(W\) | 独立模型 \(P(T,W)\) |
|---|---|---|
| hot | sun | \(0.5\times0.6=0.3\) |
| hot | rain | \(0.5\times0.4=0.2\) |
| cold | sun | \(0.5\times0.6=0.3\) |
| cold | rain | \(0.5\times0.4=0.2\) |
它与 Lecture 4 的 \((0.4,0.1,0.2,0.3)\) 联合表具有相同边际,却是不同的联合分布。边际相同不代表联合分布相同,也不能仅凭边际推断独立性。
概率模型的三种用途可以分别理解:Explanation 根据观测推断隐藏原因,例如在一个给定模型中由症状推断疾病;Prediction 根据已知条件预测结果,例如由天气预测交通;Value of Information 比较获得新信息带来的决策收益与获取成本。
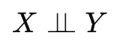
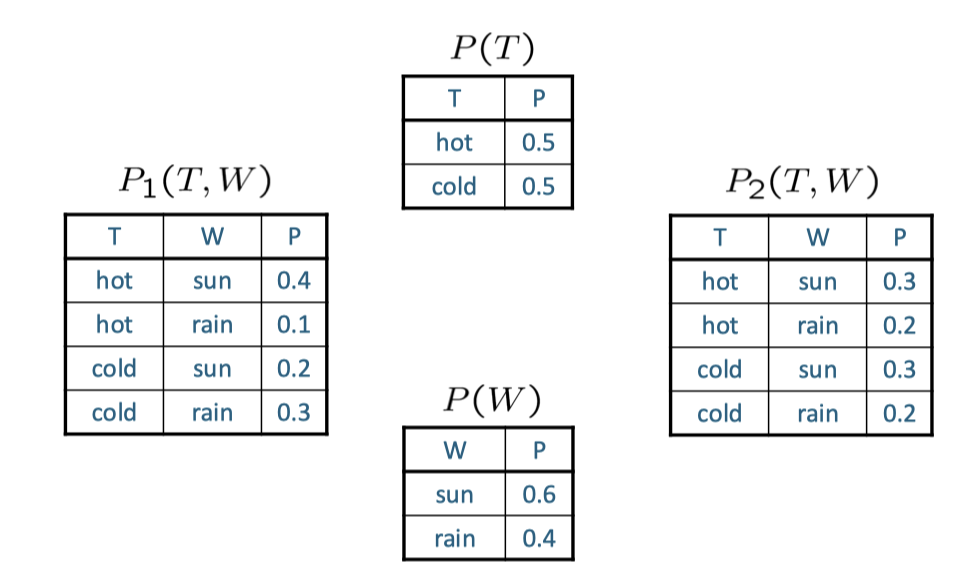
四个乘积逐一为 \(P(\mathrm{hot},\mathrm{sun})=0.5\times0.6=0.3\)、\(P(\mathrm{hot},\mathrm{rain})=0.5\times0.4=0.2\)、\(P(\mathrm{cold},\mathrm{sun})=0.5\times0.6=0.3\)、\(P(\mathrm{cold},\mathrm{rain})=0.5\times0.4=0.2\)。
复杂环境中,变量往往存在相关性;识别“给定什么之后可以独立”通常比直接假设无条件独立更适合表达局部结构。
“All models are wrong; but some are useful” 概括了概率建模的取舍:模型简化了真实世界,没有包含全部变量及其相互作用,但仍可对特定任务提供有用的解释与预测。
9.2 条件独立(Conditional Independence)
\(X\perp Y\mid Z\) 表示对于每个有正概率的 \(z\):
\[ P(x,y\mid z)=P(x\mid z)P(y\mid z). \]
等价条件是对有定义的条件概率满足
\[ P(x\mid y,z)=P(x\mid z). \]
已知 \(Z\) 后,再知道 \(Y\) 不会改变对 \(X\) 的判断。无条件独立与条件独立不相互蕴含:变量可能本来相关、给定某变量后独立,也可能本来独立、条件化后相关。
例如可在一个简化模型中假设:给定是否蛀牙(Cavity),探针卡住(Catch)与牙痛(Toothache)条件独立。这是具体模型假设,不是普遍成立的医学规律。
链式法则总成立,而条件独立允许删去部分条件。例如假设 \(U\perp T\mid R\),分别表示雨伞、交通、下雨,则
\[ P(R,T,U)=P(R)P(T\mid R)P(U\mid R,T) =P(R)P(T\mid R)P(U\mid R). \]
在牙痛、蛀牙与探针的简化模型中,条件独立具体表达为
\[ P(\mathrm{Catch}\mid\mathrm{Toothache},\mathrm{Cavity}) =P(\mathrm{Catch}\mid\mathrm{Cavity}). \]
它对有蛀牙与无蛀牙两个条件分别要求:
\[ P(+\mathrm{catch}\mid+\mathrm{toothache},+\mathrm{cavity}) =P(+\mathrm{catch}\mid+\mathrm{cavity}), \]
\[ P(+\mathrm{catch}\mid+\mathrm{toothache},-\mathrm{cavity}) =P(+\mathrm{catch}\mid-\mathrm{cavity}). \]
所用条件概率需有定义。这个假设的含义是,在给定是否蛀牙后,额外知道是否牙痛不再改变探针卡住的概率。
9.3 贝叶斯网络的表示与语义
贝叶斯网络(Bayesian network)是概率图模型的一类,由有向无环图(DAG)和各节点的局部条件分布组成:
- 节点表示随机变量。
- 箭头指定父子关系与分解形式;缺失的边配合图结构表达条件独立假设。
- 离散变量常使用条件概率表(CPT)。每个固定父节点取值下,对子节点取值的概率之和为 \(1\)。
其联合分布分解为
\[ P(x_1,\ldots,x_n)=\prod_{i=1}^nP(x_i\mid\operatorname{pa}_i), \]
其中 \(\operatorname{pa}_i\) 表示本次赋值中 \(X_i\) 的父节点取值。没有父节点时使用边际分布 \(P(x_i)\)。
箭头不自动代表因果关系;要进行因果解释,需要额外假设。存在边也不保证在每组 CPT 参数下都实际表现为统计依赖。
做推断时可以把变量分成已观测与未观测两类:例如观察到牙痛,却尚不知道是否蛀牙。给变量指定一个推测值与真实观察到该值也应区分;证据是查询中给定的信息,隐藏变量则需要边际化或推断。
直接估计完整联合分布会随变量数指数增长。贝叶斯网络利用局部 CPT 与条件独立结构组织估计任务;若父节点仍很多,局部表也可能很大,因此是否节省参数取决于具体结构。
示例一:独立抛硬币
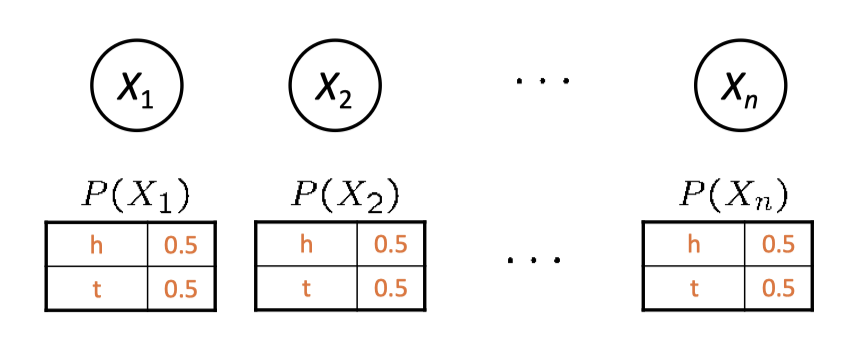
- 节点为 \(X_1,\ldots,X_n\)。
- 图中没有有向边,因此模型规定全部变量相互独立。
- 每个 CPT 就是 \(P(X_i)\);若各硬币公平,\(P(h)=P(t)=0.5\)。
没有边的网络按模型假设分解为 \(\prod_iP(X_i)\),表达的是相互独立,而不仅是两两独立。若硬币公平:
\[ P(h,h,t,h)=0.5^4=0.0625,\qquad P(h,h,h)=0.5^3=0.125. \]
示例二:报警网络
变量为入室盗窃 \(B\)、地震 \(E\)、报警 \(A\)、John 来电 \(J\)、Mary 来电 \(M\),图结构为 \(B\to A\leftarrow E\),以及 \(A\to J,A\to M\)。
图中共有五个节点、四条有向边:\(B,E\) 是根节点,\(A\) 的父节点为 \(B,E\),\(J,M\) 的父节点都是 \(A\)。例如求 \(P(+b,-e,+a,+j,-m)\) 时,分别从各表选取 \(P(+b)\)、\(P(-e)\)、\(P(+a\mid+b,-e)\)、\(P(+j\mid+a)\) 与 \(P(-m\mid+a)\) 再相乘。
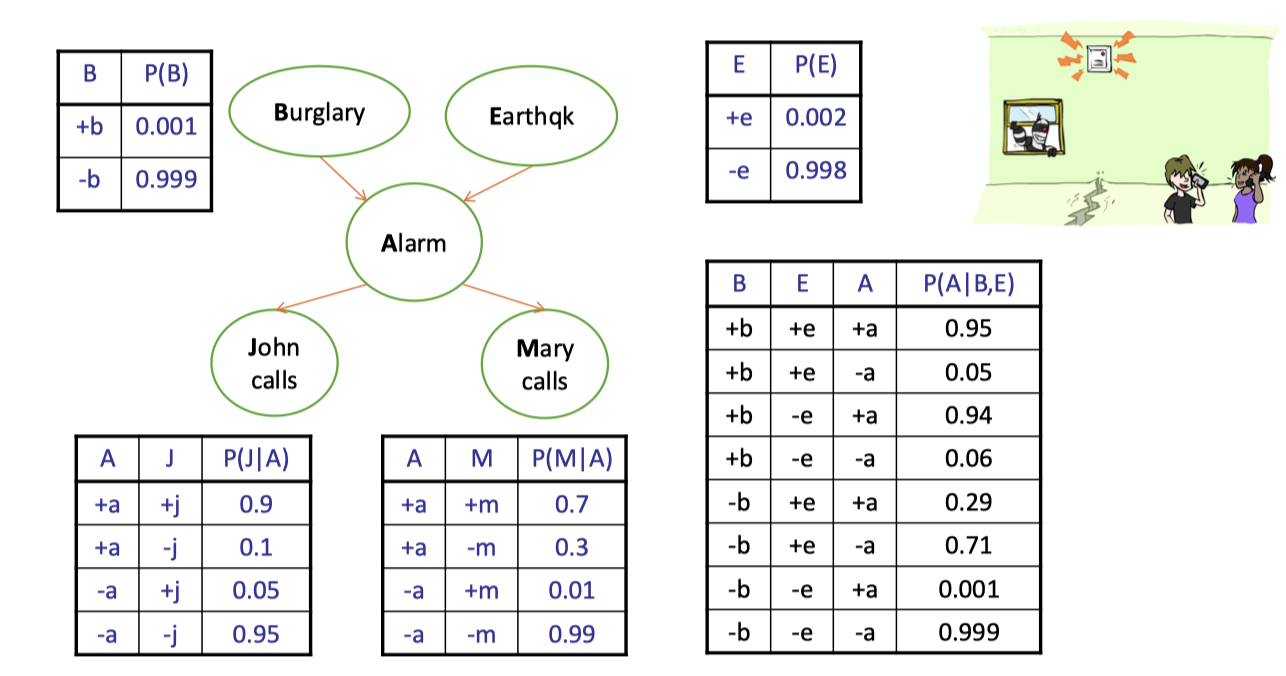
\[ P(B,E,A,J,M)=P(B)P(E)P(A\mid B,E)P(J\mid A)P(M\mid A). \]
使用图中参数:
\[ \begin{aligned} &P(+b,-e,+a,+j,-m)\\ &=0.001\times0.998\times0.94\times0.9\times0.3\\ &=0.0002532924. \end{aligned} \]
9.4 存储规模与推断难度
\(N\) 个布尔变量的完整联合表有 \(2^N\) 个条目、\(2^N-1\) 个自由参数。如果每个节点至多有 \(k\) 个布尔父节点,每个 CPT 至多有 \(2^{k+1}\) 个条目,因此完整表存储为 \(O(N2^{k+1})\);利用每行归一化,自由参数为 \(O(N2^k)\)。
父节点较少时,网络能显著节省存储,并便于分别估计局部 CPT。存储紧凑不保证任意精确推断都很快;复杂度还取决于图结构、变量消除次序及中间因子大小。
9.5 局部马尔可夫性质(Local Markov Property)
给定父节点后,一个节点与其非后代中的非父节点条件独立:
\[ X_i\perp\bigl(\operatorname{NonDesc}(X_i)\setminus\operatorname{Pa}(X_i)\bigr) \mid\operatorname{Pa}(X_i). \]
这里非后代集合不包含节点本身。例如链 \(X\to Y\to Z\to W\) 满足
\[ Z\perp X\mid Y,\qquad W\perp\{X,Y\}\mid Z. \]
后式是对集合的联合条件独立陈述,比仅分别写出两个两两独立陈述更完整。
在链 \(X\to Y\to Z\to W\) 中,逐个节点判断:
- 对 \(Z\),父节点为 \(Y\),除去父节点后的非后代是 \(X\),因此 \(Z\perp X\mid Y\)。
- 对 \(W\),父节点为 \(Z\),其余非后代是 \(X,Y\),因此 \(W\perp\{X,Y\}\mid Z\),也分别推出 \(W\perp X\mid Z\) 与 \(W\perp Y\mid Z\)。
9.6 d-分离(D-Separation)
d-分离判断图结构保证的条件独立。考虑节点之间的路径时先忽略边方向,但每个中间节点是否为碰撞点(collider),仍由原来的箭头方向决定。给定观测集合 \(Z\):
| 路径局部结构 | 中间点 \(B\) | 该处不阻断路径的条件 |
|---|---|---|
| \(A\to B\to C\) 或 \(A\leftarrow B\leftarrow C\) | 非碰撞点 | \(B\notin Z\) |
| \(A\leftarrow B\to C\) | 非碰撞点 | \(B\notin Z\) |
| \(A\to B\leftarrow C\) | 碰撞点 | \(B\) 或它的某个后代在 \(Z\) 中 |
路径上的所有中间节点都满足开放条件,路径才是活跃的(active)。若 \(X,Y\) 之间的所有路径都被阻断,则它们被 \(Z\) d-分离,推出 \(X\perp Y\mid Z\)。
若仍有活跃路径,只能说“图结构不保证独立”,不能断言任何 CPT 下都一定依赖。特殊参数可能产生额外独立性;只有再加忠实性(faithfulness)等假设,才能把二者直接对应。
示例一:碰撞结构及其后代
图为 \(R\to T\leftarrow B\),\(T\to T'\):
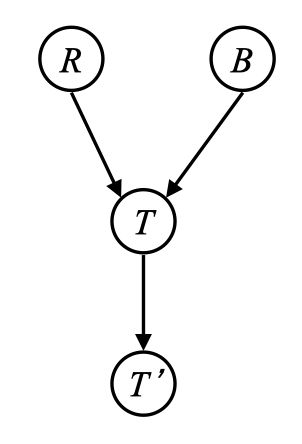
- 无观测:\(R\perp B\),唯一连接路径被碰撞点 \(T\) 阻断。
- 给定 \(T\):路径打开,通常产生条件依赖,称为解释消除(explaining away)现象。
- 给定 \(T'\):观测碰撞点后代也会打开路径,图不再保证 \(R,B\) 条件独立。
示例二:同时存在链与碰撞点
图为 \(L\to R\to T\to T'\),\(B\to T\),并有 \(R\to D\):
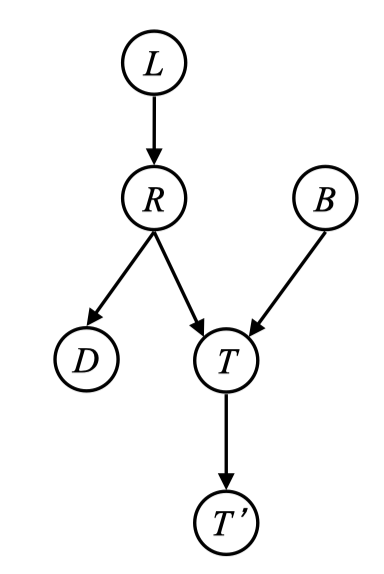
- \(L\perp T'\mid T\):路径 \(L\to R\to T\to T'\) 被已观测的非碰撞点 \(T\) 阻断。
- \(L\perp B\):路径 \(L\to R\to T\leftarrow B\) 被未观测碰撞点 \(T\) 阻断。
- 给定 \(T\) 而未给定 \(R\):上述碰撞路径打开,通常不独立。
- \(L\perp B\mid\{T,R\}\):虽然观测 \(T\) 打开碰撞点,但观测非碰撞点 \(R\) 又阻断路径。
给定集合决定哪些路径被阻断,因此“给定 \(T\)”“给定 \(R\)”与“同时给定 \(T,R\)”需要分别分析。
将示例二的路径拆成三元组
- 对 \(L\) 与 \(T'\),路径为 \(L\to R\to T\to T'\)。三元组 \(L\to R\to T\) 中 \(R\) 未给定,局部开放;\(R\to T\to T'\) 中 \(T\) 已给定,局部阻断。因此整条路径被阻断,\(L\perp T'\mid T\)。
- 对 \(L\) 与 \(B\),路径为 \(L\to R\to T\leftarrow B\)。\(L\to R\to T\) 在 \(R\) 未给定时开放;\(R\to T\leftarrow B\) 中 \(T\) 为未给定且后代未给定的碰撞点,阻断。因此 \(L\perp B\)。
- 同时给定 \(T,R\) 时,碰撞三元组 \(R\to T\leftarrow B\) 因给定 \(T\) 而开放,但链式三元组 \(L\to R\to T\) 因给定 \(R\) 而阻断,整条路径仍被阻断。因此 \(L\perp B\mid\{T,R\}\)。
“观测”“给定”和查询中的条件集合在这里指同一类条件化操作;一个路径只要有一处被阻断,就不再活跃。
9.7 推断例题:下雨、堵车与迟到
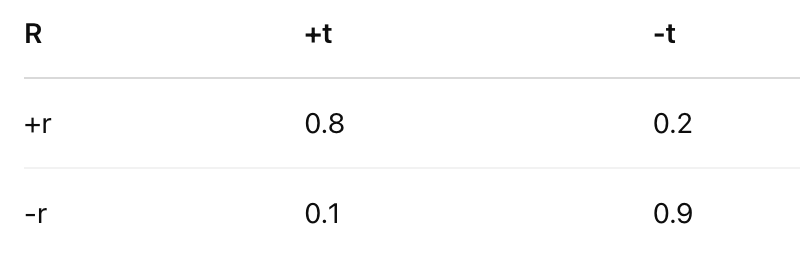
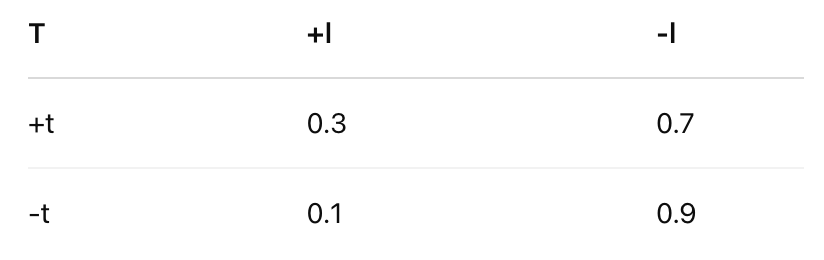
网络为 \(R\to T\to L\),分别表示下雨、堵车、迟到。使用 \(+r,-r\) 等记号表示二值取值:
\[ P(+r)=0.1,\qquad P(-r)=0.9. \]
| \(R\) | \(P(+t\mid R)\) | \(P(-t\mid R)\) |
|---|---|---|
| \(+r\) | 0.8 | 0.2 |
| \(-r\) | 0.1 | 0.9 |
| \(T\) | \(P(+l\mid T)\) | \(P(-l\mid T)\) |
|---|---|---|
| \(+t\) | 0.3 | 0.7 |
| \(-t\) | 0.1 | 0.9 |
目标是求 \(P(+l)\),联合分布为
\[ P(R,T,L)=P(R)P(T\mid R)P(L\mid T). \]
9.8 枚举推断(Inference by Enumeration)
固定查询值 \(L=+l\),对隐藏变量 \(R,T\) 的所有取值求和:
\[ P(+l)=\sum_{r\in\{+r,-r\}}\sum_{t\in\{+t,-t\}} P(r)P(t\mid r)P(+l\mid t). \]
| \(R\) | \(T\) | 对 \(P(+l)\) 的贡献 |
|---|---|---|
| \(+r\) | \(+t\) | \(0.1\times0.8\times0.3=0.024\) |
| \(+r\) | \(-t\) | \(0.1\times0.2\times0.1=0.002\) |
| \(-r\) | \(+t\) | \(0.9\times0.1\times0.3=0.027\) |
| \(-r\) | \(-t\) | \(0.9\times0.9\times0.1=0.081\) |
因此 \(P(+l)=0.024+0.002+0.027+0.081=0.134\)。
四种隐藏变量取值的逐项代入
先写联合分解 \(P(R,T,L)=P(R)P(T\mid R)P(L\mid T)\),固定查询 \(L=+l\) 后分别计算:
\[ P(+r)P(+t\mid+r)P(+l\mid+t)=0.1\times0.8\times0.3=0.024, \]
\[ P(+r)P(-t\mid+r)P(+l\mid-t)=0.1\times0.2\times0.1=0.002, \]
\[ P(-r)P(+t\mid-r)P(+l\mid+t)=0.9\times0.1\times0.3=0.027, \]
\[ P(-r)P(-t\mid-r)P(+l\mid-t)=0.9\times0.9\times0.1=0.081. \]
最后把四项相加:\(0.024+0.002+0.027+0.081=0.134\),即迟到概率为 \(13.4\%\)。
9.9 变量消除(Variable Elimination)
变量消除利用乘法与求和的分配律,重用中间结果,避免反复计算相同的子表达式。
初始因子为
\[ f_1(R)=P(R),\quad f_2(T,R)=P(T\mid R),\quad f_3(L,T)=P(L\mid T). \]
第一步:消除 \(R\)
先将所有涉及 \(R\) 的因子相乘,再对 \(R\) 求和:
\[ f_4(T,R)=f_1(R)f_2(T,R),\qquad f_5(T)=\sum_r f_4(T,r). \]
| \(R\) | \(T\) | \(f_4(T,R)\) |
|---|---|---|
| \(+r\) | \(+t\) | 0.08 |
| \(+r\) | \(-t\) | 0.02 |
| \(-r\) | \(+t\) | 0.09 |
| \(-r\) | \(-t\) | 0.81 |
所以 \(f_5(+t)=0.17\)、\(f_5(-t)=0.83\)。
第二步:消除 \(T\)
\[ f_6(L,T)=f_5(T)f_3(L,T),\qquad f_7(L)=\sum_t f_6(L,t). \]
| \(L\) | \(T\) | \(f_6(L,T)\) |
|---|---|---|
| \(+l\) | \(+t\) | \(0.17\times0.3=0.051\) |
| \(-l\) | \(+t\) | \(0.17\times0.7=0.119\) |
| \(+l\) | \(-t\) | \(0.83\times0.1=0.083\) |
| \(-l\) | \(-t\) | \(0.83\times0.9=0.747\) |
得到
\[ P(+l)=0.051+0.083=0.134,\qquad P(-l)=0.119+0.747=0.866. \]
一般查询 \(P(Q\mid e)\) 时,先用证据 \(e\) 限制因子,再消除非查询、非证据变量,最后归一化。不同消除顺序会产生不同大小的中间因子;因子不一定本身就是归一化的概率分布。
各个因子条目的逐步计算
消除 \(R\) 时,涉及 \(R\) 的初始因子是 \(f_1(R)\) 与 \(f_2(T,R)\),先相乘:
\[ \begin{aligned} f_4(+t,+r)&=P(+r)P(+t\mid+r)=0.1\times0.8=0.08,\\ f_4(-t,+r)&=P(+r)P(-t\mid+r)=0.1\times0.2=0.02,\\ f_4(+t,-r)&=P(-r)P(+t\mid-r)=0.9\times0.1=0.09,\\ f_4(-t,-r)&=P(-r)P(-t\mid-r)=0.9\times0.9=0.81. \end{aligned} \]
再对 \(R\) 的两个值求和:
\[ f_5(+t)=f_4(+t,+r)+f_4(+t,-r)=0.08+0.09=0.17, \]
\[ f_5(-t)=f_4(-t,+r)+f_4(-t,-r)=0.02+0.81=0.83. \]
此时 \(f_1,f_2\) 被它们消去 \(R\) 后的结果 \(f_5\) 替换,\(f_3(L,T)\) 保留。消除 \(T\) 时,乘起 \(f_5\) 和 \(f_3\):
\[ \begin{aligned} f_6(+l,+t)&=f_5(+t)P(+l\mid+t)=0.17\times0.3=0.051,\\ f_6(-l,+t)&=f_5(+t)P(-l\mid+t)=0.17\times0.7=0.119,\\ f_6(+l,-t)&=f_5(-t)P(+l\mid-t)=0.83\times0.1=0.083,\\ f_6(-l,-t)&=f_5(-t)P(-l\mid-t)=0.83\times0.9=0.747. \end{aligned} \]
最后分别对 \(T\) 求和:
\[ f_7(+l)=0.051+0.083=0.134,\qquad f_7(-l)=0.119+0.747=0.866. \]
结果与完整枚举一致,但 \(P(T)\) 的中间计算只需完成一次,然后可供两个 \(L\) 的取值共用。
Lecture 10: Machine Learning
10.1 机器学习与学习类型
机器学习已广泛用于计算机科学(Computer Science)、医疗健康(Healthcare)、零售(Retail)、制造(Manufacturing)、能源(Energy)与金融服务(Financial Services)。术语 “machine learning” 通常追溯到 Arthur Samuel 在 1959 年的研究。学习算法(learner)利用训练数据或交互经验捕捉所关心的规律,例如数据背后的生成分布(underlying probability distribution)的某些特征,再把模型用于新输入;模型是否能在未见数据上工作,取决于泛化能力。
机器学习(machine learning, ML)利用数据或交互经验改进模型在某类任务上的表现。其核心挑战之一是泛化(generalization):在未见过、且与目标使用场景相关的数据上仍有良好表现,而非只记住训练样本。
| 学习类型 | 训练信息 | 典型任务 |
|---|---|---|
| 监督学习 | 输入及对应目标标签 | 分类、回归 |
| 无监督学习 | 无指定预测标签的数据 | 聚类、降维、密度估计 |
| 强化学习 | 行动与环境交互产生的奖励 | 学习最大化长期回报的策略 |
无监督学习仍有优化目标和评价方式,“无标签”不等于“没有目标或反馈”。推荐系统可以使用多种学习范式,不能统一归为无监督学习。强化学习的奖励也可能延迟出现,不等于每一步都获得正确动作标签。
三种学习方式可结合具体例子理解:
- 监督学习:每个训练输入都有目标输出。分类标签可以是“猫/狗”,回归目标可以是房价或未来连续测量值。训练时可以比较预测与标签;标签本身也可能存在噪声。
- 无监督学习:没有给定要预测的类别标签,算法根据自身目标提取结构。聚类寻找相似样本分组;降维如 PCA 用更少变量保留数据的某些变化信息,类似提炼摘要,但摘要是否保留任务所需信息还需检查。模式发现与推荐可使用无监督表示,也可结合监督方法。
- 强化学习:智能体通过行动影响后续观测和奖励,例如游戏胜负或机器人避障反馈,学习能够获得较高长期回报的行动策略。
10.2 工作流程、目标函数与评价指标
典型流程为:明确任务与指标 → 收集并检查数据 → 划分数据 → 在训练部分拟合预处理和模型 → 用验证数据选择方案 → 最终测试 → 部署与监测。
- 训练目标(objective):训练时优化的函数,可包含损失与正则项,例如均方误差、交叉熵或 hinge loss。
均方误差常简称 MSE;若目标包含正则项,优化时要同时考虑拟合误差与复杂度惩罚。 - 优化算法(optimizer):如何调整参数,例如梯度下降。 - 评价指标(metric):衡量任务表现,例如准确率、F1、误差或任务收益。可在验证过程中使用,不是只能训练结束后使用。
目标函数与指标可以不同。例如分类时用交叉熵训练,再用准确率评估;要确认训练目标与真正关注的任务表现相符。
从数据和标签到模型
监督学习的基本关系为
\[ \text{Data}+\text{Target Output} \xrightarrow{\text{Learning Algorithm}}\text{Model}. \]
Data 是原始特征或观测值,Target Output 是训练标签,Computer 提供运行学习算法的计算环境,Model 则是拟合后的预测规则。使用时,把新数据输入模型,得到类别、数值或其他目标输出。
五阶段工作流程
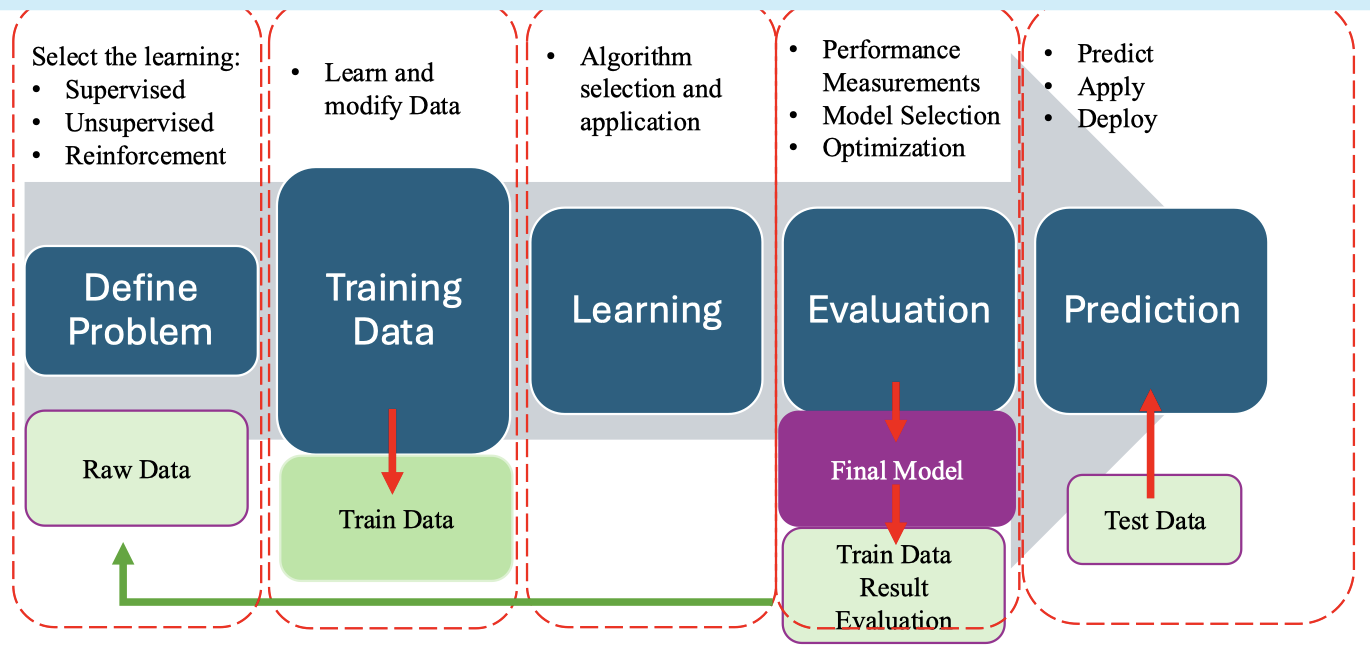
- Define Problem:输入原始数据及任务需求;明确是分类、回归、聚类还是顺序决策;选择监督、无监督或强化学习框架,并确定成功标准。
- Training Data:把原始数据转为可训练的样本;进行数据清洗、特征工程与标签处理。先划分数据,再在训练部分拟合需学习的预处理规则。
- Learning:选择决策树、神经网络等合适算法,在训练数据上拟合参数,输出候选模型。损失函数给出优化方向,梯度下降、牛顿法等算法决定如何更新参数。
- Evaluation:计算训练表现以诊断拟合情况,使用验证数据选择模型、超参数与早停时机;准确率、F1 和损失分别反映不同表现。反复调优使用验证结果,最终测试集用于方案确定后的评估。
- Prediction:把确定的模型用于测试输入或新的实际数据,输出预测,并用于部署、应用或决策支持。测试阶段若有标签,可据此评价;实际预测时目标标签通常未知。
数据质量与前期准备
“Garbage In, Garbage Out” 强调:错误、缺失、不一致、噪声过多或缺乏代表性的数据,会限制模型可学到的规律;复杂算法与充分优化不能保证补偿所有数据问题。
数据质量会限制模型效果。前期工作包括:
- EDA:检查分布、缺失、异常、类别比例和潜在数据问题。
- 预处理:缺失值处理、编码、标准化等。
- 特征构造:从已有信息构造有用的输入。
- 特征选择或提取:选择变量或学习更紧凑的表示。
标准化参数、插补规则、PCA 和特征选择等涉及数据拟合的步骤,只能在训练部分拟合,再应用于验证和测试数据。交叉验证时,这些步骤必须在每折内部重新拟合,避免数据泄漏。
EDA 可以使用直方图、散点图和描述性统计检查数据分布;预处理包括清洗、标准化或归一化、缺失值处理和类别编码。特征构造的例子包括从出生日期与观测日期计算年龄、从体重和身高计算 BMI;特征选择则去掉冗余或无关变量,特征提取可以把多个原始变量变成新的表示。
训练流程前四阶段产生并选择模型,第五阶段把模型用于新输入。预测能否准确,需要在与目标使用场景相符的未见数据上检验。
10.3 训练、验证、测试与交叉验证
| 数据部分 | 用途 | 是否参与模型选择 |
|---|---|---|
| 训练集(training set) | 拟合参数及预处理 | 是 |
| 验证集(validation set) | 超参数、模型选择、早停 | 是 |
| 测试集(test set) | 方案确定后的最终性能估计 | 否 |
可以使用 60%/10%/30% 等比例作为具体示例,但不存在所有任务都最优的划分比例。测试集结果不能被反复用于调参,否则会变成事实上的验证集,最终评估会偏乐观。
- 留出法(holdout):固定划出训练、验证、测试部分;与 K 折交叉验证不同。
- K 折交叉验证(K-fold CV):将用于开发的数据分成 \(K\) 折,每次用 \(K-1\) 折训练、剩余一折验证,汇总结果用于模型选择;最终测试集仍应保留。
- 分层、分组与时间划分:类别不平衡时可分层;同一患者或用户的重复样本应按组隔离;预测未来时通常按时间划分,避免未来信息泄漏。
交叉验证能帮助评估划分敏感性,但不保证在所有数据上降低估计方差,也不能修复泄漏或分布不匹配。训练集表现用于诊断拟合情况,不能单独证明泛化能力。推理(inference)只是使用模型计算输出;是否泛化良好仍需适当评估。
留出数据的具体比例与职责
训练—测试的简单划分可以采用 \(70\%/30\%\)、\(80\%/20\%\) 或 \(90\%/10\%\)。训练部分通常更大,以提供足够拟合信息;留出一部分数据会减少拟合样本,但能够较早估计未见数据上的表现,而不必等到部署后才发现问题。
若还要调参,可采用下面这组三部分留出例子:
- Training:60%,用于拟合模型参数和数据变换。
- Validation:10%,用于比较学习率、正则化强度、不同模型(如 SVM 与决策树),以及决定早停等训练控制。
- Test:30%,在方案最终确定后估计泛化表现。
比例只是示例,不是最优性保证。若用测试结果调整复杂度或灵活性,测试集就失去了独立最终评估的作用,这类调整应由验证集或交叉验证驱动。
固定验证集的结果可能对划分敏感,尤其数据少或验证集缺乏代表性时。K 折交叉验证通过轮流使用不同折作为验证部分来评估模型选择的稳定性,但仍需匹配时间、分组与数据分布条件。
10.4 朴素贝叶斯分类器(Naive Bayes)
设样本 \(\mathbf{x}=(x_1,\ldots,x_D)^\top\),类别 \(C\in\{C_1,\ldots,C_K\}\)。贝叶斯公式给出
\[ P(C_k\mid\mathbf{x})= \frac{P(\mathbf{x}\mid C_k)P(C_k)}{P(\mathbf{x})}, \]
\[ P(\mathbf{x})=\sum_{k=1}^KP(\mathbf{x}\mid C_k)P(C_k). \]
其中 \(P(C_k)\) 是先验,\(P(\mathbf{x}\mid C_k)\) 是类条件似然,\(P(C_k\mid\mathbf{x})\) 是后验。连续特征使用对应概率密度,不能把密度数值解释成精确取到该点的概率。
朴素贝叶斯的关键假设是:给定类别后,特征相互条件独立,即
\[ P(\mathbf{x}\mid C_k)=\prod_{j=1}^DP(x_j\mid C_k). \]
于是预测规则为
\[ \widehat{C}=\arg\max_kP(C_k)\prod_{j=1}^DP(x_j\mid C_k), \]
或使用更稳定的对数得分:
\[ \widehat{C}=\arg\max_k\left[\log P(C_k)+\sum_{j=1}^D\log P(x_j\mid C_k)\right]. \]
这里不要求特征无条件独立,不要求训练数据线性可分,也不要求各类别具有相同方差。
常见变体
| 变体 | 类条件模型 | 常见数据 |
|---|---|---|
| Bernoulli NB | 每个特征为伯努利变量 | 词是否出现等二值特征 |
| Multinomial NB | 对计数向量使用多项式模型 | 文本词频等计数 |
| Gaussian NB | 给定类别后,各特征分别服从高斯分布 | 连续数值特征 |
多项式变体对词元事件作条件独立建模;固定总次数下的计数坐标不宜再逐字理解为相互独立的随机变量。
Gaussian NB 使用
\[ p(x_j\mid C_k)=\frac{1}{\sqrt{2\pi\sigma_{kj}^2}} \exp\left[-\frac{(x_j-\mu_{kj})^2}{2\sigma_{kj}^2}\right]. \]
各类和各特征可有不同方差。若类别间方差不同,对数后验比通常包含二次项,决策边界一般不是线性的。
离散模型中,某特征在某类中未出现会产生零频率问题,可使用平滑。例如一个有 \(V\) 种取值的分类特征:
\[ \widehat{P}(X_j=v\mid C_k)=\frac{N_{kjv}+\alpha}{N_k+\alpha V},\qquad\alpha>0. \]
多项式词频模型的分母则使用该类的词元总数。平滑不能让模型自动识别训练中从未定义过的新类别。
朴素贝叶斯通常训练和预测较快,在独立性假设不完全成立时仍可能分类有效;相关特征可能导致证据重复计入,后验概率也不一定校准良好。“未见过的特征组合”本身不一定有问题,因为模型正是通过特征分解为新组合估计概率。
对同一个输入比较类别时,证据 \(P(\mathbf{x})\) 与类别下标无关,因此可以省略该共同分母,只比较“先验 × 类条件似然”;若要输出后验概率,则需把各类得分归一化。
朴素贝叶斯与 SVM、逻辑回归的效果要由具体任务验证,不能仅凭模型简单就判定表现较差。类别不平衡可通过先验概率影响预测与少数类表现;类别数量增加会增加要比较的得分数,但不表示贝叶斯公式本身变得不适用。未见类别需要新的类别定义及训练信息;离散特征的未见取值可用平滑或预设的未知值机制处理。
若以行向量记录输入,可写作 \(\mathbf{x}^\top\in\mathbb{R}^{1\times D}\);本章数学推导采用 \(\mathbf{x}\in\mathbb{R}^D\) 的列向量约定。类别 \(C_k\) 是离散标签,\(k=1,\ldots,K\);要计算的是给定这些输入特征后,标签属于哪一类的后验。
10.5 高斯朴素贝叶斯与线性判别分析(LDA)
线性判别分析(linear discriminant analysis, LDA)使用共享的完整协方差矩阵描述各类的高斯分布。它与高斯朴素贝叶斯、二次判别分析的主要区别在于协方差结构:
| 模型 | 类条件高斯协方差 | 通常的边界 |
|---|---|---|
| Gaussian NB | 每类为对角矩阵,可各不相同 | 一般为二次边界 |
| LDA | 各类共享同一个完整协方差矩阵 | 线性边界 |
| QDA | 各类使用各自的完整协方差矩阵 | 二次边界 |
高斯模型中特征条件独立对应对角协方差;完整矩阵的非零非对角元素表示类内相关性。LDA 可以看作与朴素贝叶斯不同的高斯生成式分类器。
LDA 数值例题
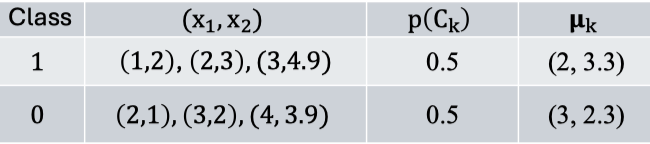
| 类别 | 样本 | 先验 | 均值 |
|---|---|---|---|
| \(C_1\) | \((1,2),(2,3),(3,4.9)\) | 0.5 | \(\boldsymbol\mu_1=(2,3.3)^\top\) |
| \(C_0\) | \((2,1),(3,2),(4,3.9)\) | 0.5 | \(\boldsymbol\mu_0=(3,2.3)^\top\) |
本例以两个高斯类共享完整协方差的 LDA 模型分类。均值与协方差按最大似然估计计算;后续需要矩阵求逆,因此中间值尽量不提前舍入。
第一步:分别求两个类别的均值
把每行看作一个样本,数据矩阵为
\[ X_1=\begin{bmatrix}1&2\\2&3\\3&4.9\end{bmatrix},\qquad X_0=\begin{bmatrix}2&1\\3&2\\4&3.9\end{bmatrix}. \]
对两列分别求平均:
\[ \boldsymbol\mu_1= \begin{bmatrix}(1+2+3)/3\\(2+3+4.9)/3\end{bmatrix} =\begin{bmatrix}2\\3.3\end{bmatrix}, \]
\[ \boldsymbol\mu_0= \begin{bmatrix}(2+3+4)/3\\(1+2+3.9)/3\end{bmatrix} =\begin{bmatrix}3\\2.3\end{bmatrix}. \]
两类样本各占一半,所以 \(\pi_1=\pi_0=3/6=0.5\)。
第二步:逐行中心化
中心化是从每行样本减去对应类均值:
\[ \begin{aligned} A_1&=X_1-\mathbf{1}\boldsymbol\mu_1^\top\\ &=\begin{bmatrix} 1-2&2-3.3\\ 2-2&3-3.3\\ 3-2&4.9-3.3 \end{bmatrix} =\begin{bmatrix}-1&-1.3\\0&-0.3\\1&1.6\end{bmatrix}. \end{aligned} \]
\[ \begin{aligned} A_0&=X_0-\mathbf{1}\boldsymbol\mu_0^\top\\ &=\begin{bmatrix} 2-3&1-2.3\\ 3-3&2-2.3\\ 4-3&3.9-2.3 \end{bmatrix} =\begin{bmatrix}-1&-1.3\\0&-0.3\\1&1.6\end{bmatrix}. \end{aligned} \]
因此本例恰好有 \(A_1=A_0\),但它们的原始样本与均值并不相同。
第三步:展开协方差矩阵的乘法
对于类别 1,最大似然类内协方差为
\[ \Sigma_1=\frac13A_1^\top A_1 =\frac13 \begin{bmatrix}-1&0&1\\-1.3&-0.3&1.6\end{bmatrix} \begin{bmatrix}-1&-1.3\\0&-0.3\\1&1.6\end{bmatrix}. \]
四个乘积条目分别为
\[ \begin{aligned} (A_1^\top A_1)_{11}&=(-1)^2+0^2+1^2=2,\\ (A_1^\top A_1)_{12}&=(-1)(-1.3)+0(-0.3)+1(1.6)=2.9,\\ (A_1^\top A_1)_{21}&=(-1.3)(-1)+(-0.3)0+1.6(1)=2.9,\\ (A_1^\top A_1)_{22}&=(-1.3)^2+(-0.3)^2+1.6^2\\ &=1.69+0.09+2.56=4.34. \end{aligned} \]
所以
\[ \Sigma_1=\frac13\begin{bmatrix}2&2.9\\2.9&4.34\end{bmatrix} =\begin{bmatrix} 0.6666667&0.9666667\\ 0.9666667&1.4466667 \end{bmatrix}. \]
类别 0 的 \(A_0\) 相同,因此 \(\Sigma_0=\Sigma_1\)。LDA 的共享最大似然协方差为
\[ \Sigma=\frac{A_1^\top A_1+A_0^\top A_0}{6} =\frac13\begin{bmatrix}2&2.9\\2.9&4.34\end{bmatrix}. \]
若改用合并无偏估计,分母为 \(N-K=4\);它与这里的最大似然估计是不同缩放,不能在同一推导中混用。
第四步:计算逆矩阵
用精确分数写出
\[ \Sigma=\begin{bmatrix}2/3&29/30\\29/30&217/150\end{bmatrix}. \]
行列式为
\[ \det\Sigma=\frac23\frac{217}{150}-\left(\frac{29}{30}\right)^2 =\frac{3}{100}=0.03. \]
使用二阶矩阵求逆公式:
\[ \begin{aligned} \Sigma^{-1} &=\frac{1}{0.03} \begin{bmatrix}217/150&-29/30\\-29/30&2/3\end{bmatrix}\\ &=\begin{bmatrix} 48.2222222&-32.2222222\\ -32.2222222&22.2222222 \end{bmatrix}. \end{aligned} \]
行列式较小使求逆对舍入较敏感;上式小数仅用于展示,计算可保留分数或完整精度。
第五步:逐项计算权重
二分类 LDA 的对数后验比为 \(h(\mathbf{x})=\mathbf{w}^\top\mathbf{x}+b\),其中
\[ \mathbf{w}=\Sigma^{-1}(\boldsymbol\mu_1-\boldsymbol\mu_0). \]
均值差为
\[ \boldsymbol\mu_1-\boldsymbol\mu_0 =\begin{bmatrix}2-3\\3.3-2.3\end{bmatrix} =\begin{bmatrix}-1\\1\end{bmatrix}. \]
代入矩阵乘法:
\[ \mathbf{w}\approx \begin{bmatrix}48.2222222&-32.2222222\\-32.2222222&22.2222222\end{bmatrix} \begin{bmatrix}-1\\1\end{bmatrix} \approx\begin{bmatrix}-80.4444444\\54.4444444\end{bmatrix}. \]
也就是 \(w_1=-48.2222222-32.2222222\),\(w_2=32.2222222+22.2222222\)。按行向量写时等价于 \(\mathbf{w}^\top=(\boldsymbol\mu_1^\top-\boldsymbol\mu_0^\top)\Sigma^{-1}\)。
第六步:分别计算偏置中的两个二次型
偏置为
\[ b=\frac12\left( \boldsymbol\mu_0^\top\Sigma^{-1}\boldsymbol\mu_0 -\boldsymbol\mu_1^\top\Sigma^{-1}\boldsymbol\mu_1\right) +\log\frac{\pi_1}{\pi_0}. \]
先求类别 0 的矩阵—向量乘积:
\[ \Sigma^{-1}\boldsymbol\mu_0\approx \begin{bmatrix}48.2222222&-32.2222222\\-32.2222222&22.2222222\end{bmatrix} \begin{bmatrix}3\\2.3\end{bmatrix} \approx\begin{bmatrix}70.5555556\\-45.5555556\end{bmatrix}. \]
再左乘均值行向量:
\[ \boldsymbol\mu_0^\top\Sigma^{-1}\boldsymbol\mu_0 =3(70.5555556)+2.3(-45.5555556) \approx106.8888889. \]
同样计算类别 1:
\[ \Sigma^{-1}\boldsymbol\mu_1\approx \begin{bmatrix}48.2222222&-32.2222222\\-32.2222222&22.2222222\end{bmatrix} \begin{bmatrix}2\\3.3\end{bmatrix} \approx\begin{bmatrix}-9.8888889\\8.8888889\end{bmatrix}, \]
\[ \boldsymbol\mu_1^\top\Sigma^{-1}\boldsymbol\mu_1 =2(-9.8888889)+3.3(8.8888889) \approx9.5555556. \]
两类先验相同,所以 \(\log(\pi_1/\pi_0)=\log(0.5/0.5)=0\),得到
\[ b=\frac12(106.8888889-9.5555556)+0\approx48.6666667. \]
第七步:写出分类函数与后验概率
\[ \begin{aligned} h(\mathbf{x})&=-\frac{724}{9}x_1+\frac{490}{9}x_2+\frac{146}{3}\\ &\approx-80.4444444x_1+54.4444444x_2+48.6666667. \end{aligned} \]
\[ P(C_1\mid\mathbf{x})=\sigma(h(\mathbf{x})) =\frac{1}{1+\exp[-h(\mathbf{x})]}. \]
以 \(0.5\) 为概率阈值:
\[ \widehat y=\begin{cases} 1,&P(C_1\mid\mathbf{x})\geq0.5,\\ 0,&P(C_1\mid\mathbf{x})<0.5. \end{cases} \]
等价地,\(h(\mathbf{x})\geq0\) 判为 \(C_1\),否则判为 \(C_0\)。LDA 的 sigmoid 后验来自高斯生成式模型;逻辑回归直接拟合条件类别概率,两者的训练方式不同。
10.6 感知机(Perceptron)
感知机学习线性二分类边界,标签 \(y_i\in\{-1,+1\}\):
\[ h(\mathbf{x})=\mathbf{w}^\top\mathbf{x}+b, \qquad \widehat{y}=\begin{cases} +1,&h(\mathbf{x})\geq0,\\ -1,&h(\mathbf{x})<0. \end{cases} \]
\(\mathbf{w}\) 是超平面的法向量,\(b\) 决定偏移。在二维、\(w_2\ne0\) 时,边界为
\[ x_2=-\frac{w_1}{w_2}x_1-\frac{b}{w_2}. \]
因此斜率不是权重向量本身,截距也不一定直接等于 \(b\)。
为统一偏置,可令 \(\widetilde{\mathbf{x}}=(1,x_1,\ldots,x_D)^\top\),\(\widetilde{\mathbf{w}}=(b,w_1,\ldots,w_D)^\top\),则 \(h=\widetilde{\mathbf{w}}^\top\widetilde{\mathbf{x}}\)。
损失与更新
常用感知机损失为
\[ L(\mathbf{w},b)=\sum_i\max\{0,-y_i(\mathbf{w}^\top\mathbf{x}_i+b)\}. \]
当 \(y_i h(\mathbf{x}_i)<0\),该样本被误分类;边界上的 \(h=0\) 需另行规定处理方式。常用更新规则把 \(y_i h(\mathbf{x}_i)\leq0\) 都视为需要更新,包括恰在边界上的样本:
\[ \mathbf{w}\leftarrow\mathbf{w}+\eta y_i\mathbf{x}_i, \qquad b\leftarrow b+\eta y_i,\qquad\eta>0. \]
其余样本不更新。该规则可以解释为对感知机损失进行逐样本的次梯度更新。训练样本可以固定顺序,也可以每轮打乱;样本顺序会影响更新过程。
若有限训练集严格线性可分,经典感知机在标准条件下有限次更新后找到分隔面;不可分时可能持续振荡。最终边界依赖初始化与样本顺序,也不保证最大间隔或最佳测试表现。感知机损失是凸函数,但训练目标并不包含最大间隔要求。
数值例题:学习率为 \(1\)
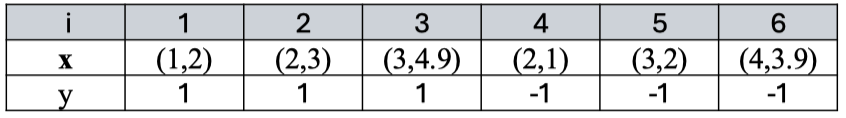
使用上一节六个样本,其中 \(C_1\) 标签为 \(+1\),\(C_0\) 标签为 \(-1\)。初始增广权重为 \((5,-6,1)^\top\),即 \(h=5-6x_1+x_2\):
| 样本 | \(y\) | 更新前 \(h\) | 操作 | 更新后 \((b,w_1,w_2)\) |
|---|---|---|---|---|
| \((1,2)\) | +1 | \(5-6+2=1\) | 正确,不更新 | \((5,-6,1)\) |
| \((2,3)\) | +1 | \(5-12+3=-4\) | 加 \((1,2,3)\) | \((6,-4,4)\) |
| \((3,4.9)\) | +1 | \(6-12+19.6=13.6\) | 正确,不更新 | \((6,-4,4)\) |
| \((2,1)\) | -1 | \(6-8+4=2\) | 减 \((1,2,1)\) | \((5,-6,3)\) |
| \((3,2)\) | -1 | \(5-18+6=-7\) | 正确,不更新 | \((5,-6,3)\) |
| \((4,3.9)\) | -1 | \(5-24+11.7=-7.3\) | 正确,不更新 | \((5,-6,3)\) |
一轮结束后应重新检查整个训练集,因为后续更新可能改变前面样本的分类。本例最终权重对三个正类的得分为 \(5,2,1.7\),对三个负类的得分为 \(-4,-7,-7.3\),均分类正确;再运行一轮将不会发生更新,因而已找到分隔面。
感知机准则与更新的逐项写法
令误分类集合为 \(\mathcal{M}=\{i:y_i h(\mathbf{x}_i)<0\}\),则忽略边界零损失项时,感知机准则可写为
\[ E_p(\mathbf{w},b)=-\sum_{i\in\mathcal M}y_i h(\mathbf{x}_i) =-\sum_{i\in\mathcal M}y_i(\mathbf{w}^\top\mathbf{x}_i+b). \]
它与前面的 \(\sum_i\max(0,-y_i h_i)\) 相同。使用增广向量时,误分类或零间隔样本的更新是
\[ \widetilde{\mathbf{w}}^{(\tau+1)}= \widetilde{\mathbf{w}}^{(\tau)}+\eta y_i\widetilde{\mathbf{x}}_i. \]
正间隔样本保持 \(\widetilde{\mathbf{w}}^{(\tau+1)}=\widetilde{\mathbf{w}}^{(\tau)}\)。靠近边界时,小幅改变参数可能改变阶跃分类结果;训练使用的是该损失的更新规则,不是对阶跃函数直接求梯度。
六个样本的逐步演示
- 初始化:\(\widetilde{\mathbf{w}}^{(0)}=(5,-6,1)^\top\),即 \(h=5-6x_1+x_2\),学习率 \(\eta=1\)。
- 样本 \((1,2)\),标签 \(+1\):增广输入为 \((1,1,2)^\top\)。
\[ h=5+(-6)\times1+1\times2=1>0, \qquad\widehat y=+1. \]
预测正确,不更新。
- 样本 \((2,3)\),标签 \(+1\):增广输入为 \((1,2,3)^\top\)。
\[ h=5+(-6)\times2+1\times3=-4<0,\qquad\widehat y=-1. \]
预测错误,执行
\[ \widetilde{\mathbf{w}}^{(1)} =(5,-6,1)^\top+1\times(+1)(1,2,3)^\top =(6,-4,4)^\top. \]
- 样本 \((3,4.9)\),标签 \(+1\):使用更新后的权重。
\[ h=6+(-4)\times3+4\times4.9 =6-12+19.6=13.6>0. \]
预测正确,权重保持 \((6,-4,4)^\top\)。
- 样本 \((2,1)\),标签 \(-1\):
\[ h=6+(-4)\times2+4\times1=2>0, \qquad\widehat y=+1\ne-1. \]
执行负类更新:
\[ \widetilde{\mathbf{w}}^{(2)} =(6,-4,4)^\top+1\times(-1)(1,2,1)^\top =(5,-6,3)^\top. \]
- 样本 \((3,2)\),标签 \(-1\):
\[ h=5+(-6)\times3+3\times2=-7<0, \]
预测正确,不更新。
- 样本 \((4,3.9)\),标签 \(-1\):
\[ h=5+(-6)\times4+3\times3.9=-7.3<0, \]
预测正确,不更新。本轮结束后重新检查全部训练样本;本例六个样本都具有正的有符号间隔,下一轮不会更新。
10.7 支持向量机(Support Vector Machine, SVM)
感知机只要求找到某个分隔面;SVM 通过最大间隔原则和正则化选择边界。最大间隔可以帮助控制模型复杂度,但不保证所有数据分布上的泛化误差最小,也不要求所有样本到边界的距离相同。
硬间隔线性 SVM
对线性可分数据,令 \(h(\mathbf{x})=\mathbf{w}^\top\mathbf{x}+b\),求解
\[ \begin{aligned} \min_{\mathbf{w},b}\quad &\frac12\|\mathbf{w}\|_2^2\\ \text{s.t.}\quad &y_i(\mathbf{w}^\top\mathbf{x}_i+b)\geq1, \quad i=1,\ldots,N. \end{aligned} \]
\(1\) 是规范化后的函数间隔下界;点到决策边界的几何距离为
\[ \frac{|\mathbf{w}^\top\mathbf{x}+b|}{\|\mathbf{w}\|_2}. \]
在上述规范化下,最近点到边界为 \(1/\|\mathbf{w}\|_2\),两个支持超平面间宽度为 \(2/\|\mathbf{w}\|_2\);约束中的函数间隔与几何距离相差权重范数这一缩放因子。
软间隔 SVM
不可分或含噪数据可引入松弛变量:
\[ \begin{aligned} \min_{\mathbf{w},b,\boldsymbol\xi}\quad &\frac12\|\mathbf{w}\|_2^2+C\sum_i\xi_i\\ \text{s.t.}\quad &y_i(\mathbf{w}^\top\mathbf{x}_i+b)\geq1-\xi_i,\qquad\xi_i\geq0. \end{aligned} \]
\(C>0\) 控制间隔与违规惩罚的权衡;等价形式使用 hinge loss \(\max(0,1-y_ih(\mathbf{x}_i))\)。固定合法核与 \(C\) 后,标准 SVM 训练是凸优化,可以求全局最优;超参数选择不是同一个优化问题。
与朴素贝叶斯和感知机的比较
| 方法 | 建模或训练原则 | 关键条件 |
|---|---|---|
| 朴素贝叶斯 | 用类别先验与特征类条件分布计算后验 | 给定类别后的特征条件独立假设;高斯假设属于连续特征似然的一种选择 |
| 感知机 | 对错误或零间隔样本进行线性权重更新 | 经典有限次收敛保证要求训练样本严格线性可分;可先进行非线性特征映射 |
| SVM | 在分类约束与正则化之间优化间隔 | 硬间隔要求可分;软间隔允许违规;合法核下训练目标为凸问题 |
SVM 直接优化几何边界,不以生成输入数据的概率模型为基础。线性模型仍写为 \(h(\mathbf{x})=b+w_1x_1+w_2x_2\);预测取其符号,恰为零时采用预先约定的平局规则。
10.8 SVM 的对偶、支持向量与偏置
硬间隔拉格朗日函数为
\[ \mathcal{L}(\mathbf{w},b,\boldsymbol\alpha) =\frac12\|\mathbf{w}\|_2^2 -\sum_i\alpha_i\bigl[y_i(\mathbf{w}^\top\mathbf{x}_i+b)-1\bigr], \quad\alpha_i\geq0. \]
驻点条件给出
\[ \mathbf{w}=\sum_i\alpha_iy_i\mathbf{x}_i,\qquad \sum_i\alpha_iy_i=0. \]
对偶问题为
\[ \begin{aligned} \max_{\boldsymbol\alpha}\quad &\sum_i\alpha_i-\frac12\sum_i\sum_j \alpha_i\alpha_jy_iy_j\mathbf{x}_i^\top\mathbf{x}_j\\ \text{s.t.}\quad &\alpha_i\geq0,\qquad\sum_i\alpha_iy_i=0. \end{aligned} \]
软间隔增加上界 \(\alpha_i\leq C\)。各乘子由对偶优化问题共同确定,需同时满足可行性、驻点与互补松弛条件。
互补松弛条件为
\[ \alpha_i\bigl[y_i h(\mathbf{x}_i)-1\bigr]=0. \]
硬间隔下,\(\alpha_i>0\) 的支持向量满足 \(y_i h(\mathbf{x}_i)=1\),因此
\[ b=y_i-\mathbf{w}^\top\mathbf{x}_i. \]
通常对这些支持向量求平均,分母应为所用支持向量数量 \(|S_{\mathrm{SV}}|\):
\[ b=\frac{1}{|S_{\mathrm{SV}}|}\sum_{i\in S_{\mathrm{SV}}} \bigl(y_i-\mathbf{w}^\top\mathbf{x}_i\bigr). \]
软间隔应使用 \(0<\alpha_i<C\) 的间隔上支持向量;\(\alpha_i=C\) 的样本可能落在间隔内,甚至误分类,不能直接套用等式。如果没有合适向量,需要用 KKT 给出的偏置界等方法处理。
“只有支持向量出现在最终预测和式中”是指固定已求出的对偶解;不是说改变其他训练样本永远不会改变重新训练后的模型。
驻点条件的来源可以逐项求导:
\[ \frac{\partial\mathcal L}{\partial\mathbf w} =\mathbf w-\sum_i\alpha_i y_i\mathbf x_i=0 \quad\Longrightarrow\quad \mathbf w=\sum_i\alpha_i y_i\mathbf x_i, \]
\[ \frac{\partial\mathcal L}{\partial b}=-\sum_i\alpha_i y_i=0. \]
再把 \(\mathbf w\) 的表达代回拉格朗日函数,得到对偶目标。乘子、间隔约束和互补松弛必须共同满足,才能把代数表达式确定为训练问题的最优解。
10.9 线性 SVM 数值例题
本例有六个二维样本,与 LDA、感知机例题使用的数据不同:
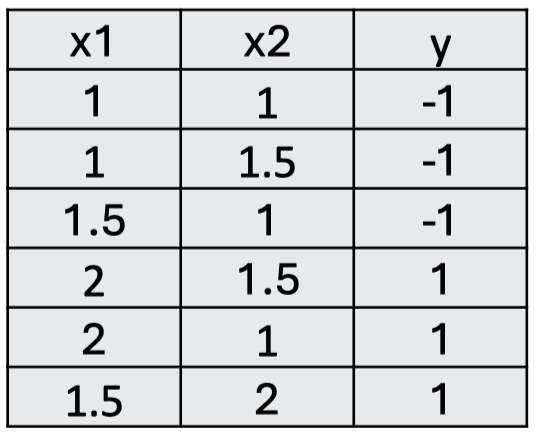
| \(i\) | \(x_{i1}\) | \(x_{i2}\) | \(y_i\) |
|---|---|---|---|
| 1 | 1 | 1 | -1 |
| 2 | 1 | 1.5 | -1 |
| 3 | 1.5 | 1 | -1 |
| 4 | 2 | 1.5 | +1 |
| 5 | 2 | 1 | +1 |
| 6 | 1.5 | 2 | +1 |
例一:所有乘子暂取 1 的代数计算
这组设置用于检验计算与最优性条件,不预先假定它是训练出的 SVM 解。
第一步:计算正、负类向量和。
\[ \sum_{y_i=+1}\mathbf{x}_i =\begin{bmatrix}2+2+1.5\\1.5+1+2\end{bmatrix} =\begin{bmatrix}5.5\\4.5\end{bmatrix}, \]
\[ \sum_{y_i=-1}\mathbf{x}_i =\begin{bmatrix}1+1+1.5\\1+1.5+1\end{bmatrix} =\begin{bmatrix}3.5\\3.5\end{bmatrix}. \]
因为暂设 \(\alpha_i=1\),所以
\[ \mathbf w=\sum_i\alpha_i y_i\mathbf x_i =\begin{bmatrix}5.5-3.5\\4.5-3.5\end{bmatrix} =\begin{bmatrix}2\\1\end{bmatrix}. \]
第二步:逐样本计算 \(y_i-\mathbf w^\top\mathbf x_i\)。
\[ \begin{aligned} \beta_1&=-1-(2\times1+1\times1)=-4,\\ \beta_2&=-1-(2\times1+1\times1.5)=-4.5,\\ \beta_3&=-1-(2\times1.5+1\times1)=-5,\\ \beta_4&=+1-(2\times2+1\times1.5)=-4.5,\\ \beta_5&=+1-(2\times2+1\times1)=-4,\\ \beta_6&=+1-(2\times1.5+1\times2)=-4. \end{aligned} \]
这些数值不同,已经说明它们不能全都被当成满足间隔等式的支持向量。若仍取全部条目的平均作为一个候选偏置:
\[ b_{\mathrm{candidate}} =\frac{-4-4.5-5-4.5-4-4}{6} =-\frac{26}{6}=-\frac{13}{3}\approx-4.333333. \]
第三步:写出候选分类器并检查。
\[ h_{\mathrm{candidate}}(\mathbf x)=2x_1+x_2-\frac{13}{3}. \]
按符号分类时,它可以分开这六个点;但第 \(3\) 个样本的函数间隔为
\[ y_3h_{\mathrm{candidate}}(\mathbf x_3) =(-1)\left(2\times1.5+1-\frac{13}{3}\right)=\frac13<1. \]
所以它不是规范化硬间隔问题的可行解,更不是已经验证的 SVM 最优解。支持向量偏置公式适用于满足 KKT 条件的向量,不能仅用任意设置的乘子与全体样本平均来求训练解。
例二:给定最优乘子,逐步计算分类器
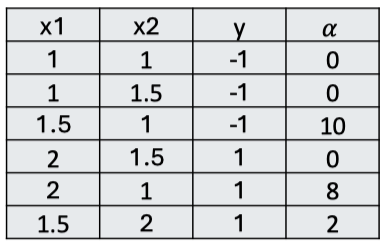
第一步:检查乘子约束。
所有乘子均非负,而且
\[ \sum_i\alpha_i y_i=-10+8+2=0. \]
第二步:计算每个非零项的向量贡献。
\[ \alpha_3y_3\mathbf x_3=10(-1)(1.5,1)^\top=(-15,-10)^\top, \]
\[ \alpha_5y_5\mathbf x_5=8(+1)(2,1)^\top=(16,8)^\top, \]
\[ \alpha_6y_6\mathbf x_6=2(+1)(1.5,2)^\top=(3,4)^\top. \]
其余乘子为零,不贡献到和式。相加得到
\[ \mathbf w=(-15+16+3,-10+8+4)^\top=(4,2)^\top. \]
第三步:分别用三个支持向量计算偏置。
\[ b_3=-1-(4\times1.5+2\times1)=-1-8=-9, \]
\[ b_5=+1-(4\times2+2\times1)=1-10=-9, \]
\[ b_6=+1-(4\times1.5+2\times2)=1-10=-9. \]
三项一致,其平均为
\[ b=\frac{b_3+b_5+b_6}{3} =\frac{-9+(-9)+(-9)}{3}=-9. \]
分母为本次使用的三个支持向量数量,不是总样本数六。
第四步:得到决策函数与分类规则。
\[ h(\mathbf x)=4x_1+2x_2-9, \qquad \widehat y=\begin{cases}+1,&h(\mathbf x)\geq0,\\-1,&h(\mathbf x)<0.\end{cases} \]
第五步:检查全部训练样本。
| \(i\) | \(h(\mathbf x_i)\) | \(y_i h(\mathbf x_i)\) | 是否在间隔上 |
|---|---|---|---|
| 1 | \(4+2-9=-3\) | 3 | 否 |
| 2 | \(4+3-9=-2\) | 2 | 否 |
| 3 | \(6+2-9=-1\) | 1 | 是 |
| 4 | \(8+3-9=2\) | 2 | 否 |
| 5 | \(8+2-9=1\) | 1 | 是 |
| 6 | \(6+4-9=1\) | 1 | 是 |
原始约束、对偶约束、驻点与互补松弛均满足,因此这是一组硬间隔最优解。支持向量为 \(3,5,6\);几何半间隔为 \(1/\sqrt{20}\),总宽度为 \(2/\sqrt{20}\)。
10.10 非线性特征映射与核(Kernels)
线性不可分时,可以先做特征映射 \(\phi(\mathbf{x})\),再在特征空间学习线性边界。例如
\[ \phi(x_1,x_2)=(x_1,x_2,x_1^2+x_2^2)^\top. \]
一维数据也可以映射为 \((x,x^2)\) 等。只把 \(x\) 换成 \(x^2\) 并不必然增加维度,也不保证可分;应明确实际映射及任务需要。
核函数通过
\[ K(\mathbf{x},\mathbf{z})=\langle\phi(\mathbf{x}),\phi(\mathbf{z})\rangle \]
直接计算特征空间内积,不必显式构造全部特征。标准 SVM 使用对称半正定核;并非任意“相似度函数”都满足要求。
| 核 | 定义 | 特点 |
|---|---|---|
| 线性核 | \(K(\mathbf{x},\mathbf{z})=\mathbf{x}^\top\mathbf{z}\) | 对应原始特征内积 |
| 二次多项式核 | \(K(\mathbf{x},\mathbf{z})=(\mathbf{x}^\top\mathbf{z}+1)^2\) | 包含常数、线性及二次交叉项 |
| RBF 核 | \(K(\mathbf{x},\mathbf{z})=\exp(-\gamma_K\|\mathbf{x}-\mathbf{z}\|_2^2)\) | \(\gamma_K>0\),控制相似性衰减 |
RBF 常写 \(\gamma_K=1/(2\sigma^2)\)。这里使用下标 \(K\),避免与 MDP 的折扣因子混淆。RBF 的精确特征表示通常是无限维,可以进行有限维近似,但不是有限个简单多项式项的精确展开。
例如,二维二次核有显式映射
\[ \phi(x_1,x_2)= (1,\sqrt2x_1,\sqrt2x_2,x_1^2,\sqrt2x_1x_2,x_2^2)^\top. \]
直接计算可验证 \(\phi(\mathbf{x})^\top\phi(\mathbf{z})=(\mathbf{x}^\top\mathbf{z}+1)^2\)。手动“添加一些平方和交叉项”只有在项与缩放正确时才与指定核完全等价。
核 SVM 的预测式
将对偶目标中的内积换为核函数后,重新求解乘子,预测为
\[ h(\mathbf{x})=\sum_{i=1}^N\alpha_iy_iK(\mathbf{x}_i,\mathbf{x})+b. \]
在线性核下,它等于 \((\sum_i\alpha_iy_i\mathbf{x}_i)^\top\mathbf{x}+b\),与原始线性表示一致。对满足间隔等式的支持向量 \(s\):
\[ b=y_s-\sum_i\alpha_iy_iK(\mathbf{x}_i,\mathbf{x}_s). \]
硬间隔可用 \(\alpha_s>0\) 的支持向量,软间隔应使用 \(0<\alpha_s<C\) 的向量。
核方法可避免显式构造高维特征,但不保证训练更快:核矩阵存储可能达到 \(O(N^2)\),训练也可能昂贵。预测通常只对 \(\alpha_i>0\) 的支持向量计算核值,不必对所有训练样本都计算。固定维度的显式线性 SVM 可用固定长度的参数向量表示;常用 RBF 核 SVM 的支持向量数可随样本量增长,常据此称为非参数方法。这一区分取决于模型表示,不能简单把所有“非线性 SVM”都归成同一种参数类别。
分别代入三个常用核
从 \(h(\mathbf x)=\sum_i\alpha_i y_iK(\mathbf x_i,\mathbf x)+b\) 出发:
- 线性核:
\[ \begin{aligned} h_{\mathrm{linear}}(\mathbf x) &=\sum_i\alpha_i y_i\mathbf x_i^\top\mathbf x+b\\ &=\left(\sum_i\alpha_i y_i\mathbf x_i\right)^\top\mathbf x+b =\mathbf w^\top\mathbf x+b. \end{aligned} \]
- 二次核:
\[ h_{\mathrm{quadratic}}(\mathbf x) =\sum_i\alpha_i y_i(\mathbf x_i^\top\mathbf x+1)^2+b. \]
- RBF 核:
\[ h_{\mathrm{RBF}}(\mathbf x) =\sum_i\alpha_i y_i\exp[-\gamma_K\|\mathbf x_i-\mathbf x\|_2^2]+b. \]
核函数的两个参数可以是任意两个输入点;在训练后的预测和式里,非零系数对应的训练点是支持向量,新输入是待分类样本。
也可以显式构造特征后使用线性分类算法,无须改变其线性决策形式。核技巧的作用是直接得到这些高维特征的内积;当特征维数很大甚至无限时,避免完整展开尤其有用,但计算核矩阵与逐支持向量预测也有成本。
10.11 二次核 SVM 数值例题
对 10.9 节的六个输入与标签使用二次核 \(K(\mathbf x,\mathbf z)=(\mathbf x^\top\mathbf z+1)^2\)。核矩阵改变后,对偶目标和最优乘子随之改变。
第一步:逐样本展开带标签的核项
把待分类点写为 \(\mathbf x=(x_1,x_2)^\top\),则
\[ y_1K(\mathbf x_1,\mathbf x)=-(x_1+x_2+1)^2, \]
\[ y_2K(\mathbf x_2,\mathbf x)=-(x_1+1.5x_2+1)^2, \]
\[ y_3K(\mathbf x_3,\mathbf x)=-(1.5x_1+x_2+1)^2, \]
\[ y_4K(\mathbf x_4,\mathbf x)=+(2x_1+1.5x_2+1)^2, \]
\[ y_5K(\mathbf x_5,\mathbf x)=+(2x_1+x_2+1)^2, \]
\[ y_6K(\mathbf x_6,\mathbf x)=+(1.5x_1+2x_2+1)^2. \]
第二步:暂设全部乘子为 1,展开候选函数
这个暂设用于计算演示与最优性检查,不预先认定为训练解:
\[ \begin{aligned} h_{\mathrm{candidate}}(\mathbf x)= &-(x_1+x_2+1)^2\\ &-(x_1+1.5x_2+1)^2\\ &-(1.5x_1+x_2+1)^2\\ &+(2x_1+1.5x_2+1)^2\\ &+(2x_1+x_2+1)^2\\ &+(1.5x_1+2x_2+1)^2+b. \end{aligned} \]
第三步:选取第 3 个样本计算各核值
取 \(\mathbf x_3=(1.5,1)^\top\),逐项计算:
| \(i\) | 内积加 1 的具体计算 | \(K(\mathbf x_i,\mathbf x_3)\) |
|---|---|---|
| 1 | \(1\times1.5+1\times1+1=3.5\) | \(3.5^2=12.25\) |
| 2 | \(1\times1.5+1.5\times1+1=4\) | \(4^2=16\) |
| 3 | \(1.5\times1.5+1\times1+1=4.25\) | \(4.25^2=18.0625\) |
| 4 | \(2\times1.5+1.5\times1+1=5.5\) | \(5.5^2=30.25\) |
| 5 | \(2\times1.5+1\times1+1=5\) | \(5^2=25\) |
| 6 | \(1.5\times1.5+2\times1+1=5.25\) | \(5.25^2=27.5625\) |
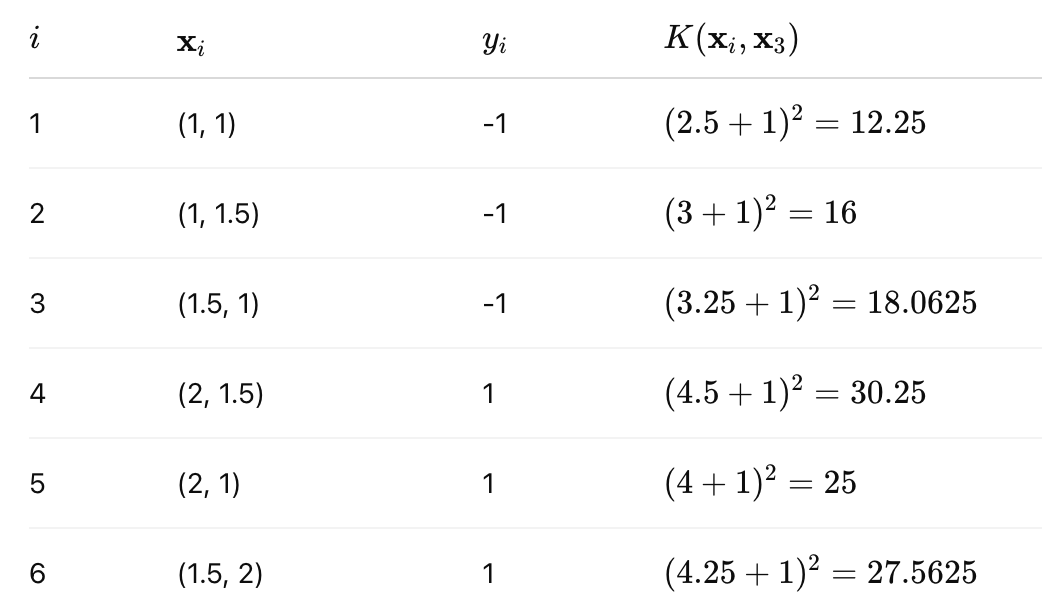
第四步:加权求和并构造候选偏置
由于暂设 \(\alpha_i=1\):
\[ \begin{aligned} \sum_{i=1}^6\alpha_i y_iK(\mathbf x_i,\mathbf x_3) ={}&-12.25-16-18.0625\\ &+30.25+25+27.5625\\ ={}&36.5. \end{aligned} \]
若令第 \(3\) 个样本满足 \(h(\mathbf x_3)=y_3=-1\),则
\[ b=y_3-\sum_i\alpha_i y_iK(\mathbf x_i,\mathbf x_3) =-1-36.5=-37.5. \]
这个等式只约束了一个样本,不能代替对整个对偶问题的求解。代入六个样本可得候选得分
\[ (-14.5,-5.75,-1,28.25,15.5,22). \]
全部 \(\alpha_i=1>0\),却只有第 \(3\) 个样本满足 \(y_i h_i=1\),其余均不满足互补松弛,因此这组参数不是 SVM 最优解。
第五步:由活跃约束求二次核最优乘子
可以在候选支持向量集合上联立 KKT 方程,再检查全部数据的可行性。本例取候选集合 \(\{3,5,6\}\),其余乘子为 \(0\)。记
\[ a=\alpha_3,\qquad p=\alpha_5,\qquad q=\alpha_6. \]
乘子等式约束为 \(-a+p+q=0\),即 \(a=p+q\)。三个候选点的核子矩阵为
\[ K_{\mathrm{SV}}= \begin{bmatrix} 289/16&25&441/16\\ 25&36&36\\ 441/16&36&841/16 \end{bmatrix}. \]
要求负类支持向量的得分为 \(-1\)、两个正类支持向量的得分为 \(+1\):
\[ \begin{aligned} -\frac{289}{16}a+25p+\frac{441}{16}q+b&=-1,\\ -25a+36p+36q+b&=1,\\ -\frac{441}{16}a+36p+\frac{841}{16}q+b&=1. \end{aligned} \]
用第二式减第一式、第三式减第一式,并代入 \(a=p+q\),消去 \(a,b\):
\[ 65p+24q=32,\qquad24p+248q=32. \]
求解这个二阶线性系统:
\[ \Delta=65\times248-24^2=15544, \]
\[ p=\frac{32\times248-24\times32}{15544} =\frac{896}{1943}, \]
\[ q=\frac{65\times32-24\times32}{15544} =\frac{164}{1943},\qquad a=p+q=\frac{1060}{1943}. \]
再代回第一个支持向量方程:
\[ \begin{aligned} b&=-1+\frac{289}{16}\frac{1060}{1943} -25\frac{896}{1943} -\frac{441}{16}\frac{164}{1943}\\ &=-\frac{9717}{1943}. \end{aligned} \]
候选乘子均为正,其余为零,且 \(-1060+896+164=0\)。这一支持集合还需通过下一步的全部约束检查,才能确认为最优解。
第六步:写出并验证决策函数
\[ \boldsymbol\alpha= \left(0,0,\frac{1060}{1943},0,\frac{896}{1943},\frac{164}{1943}\right)^\top, \qquad b=-\frac{9717}{1943}, \]
\[ \begin{aligned} h(\mathbf x)=\frac{1}{1943}\bigl[&-1060(1.5x_1+x_2+1)^2\\ &+896(2x_1+x_2+1)^2\\ &+164(1.5x_1+2x_2+1)^2-9717\bigr]. \end{aligned} \]
对六个样本的函数间隔约为
\[ (2.59650,1.83839,1,2.11529,1,1). \]
全部满足硬间隔约束,非零乘子对应的第 \(3,5,6\) 个样本满足间隔等式;驻点、对偶可行性与互补松弛均成立,因此得到最优解。最后按 \(h(\mathbf x)\) 的符号预测,恰为零时使用预先规定的平局规则。
10.12 聚类与 K-means
聚类(clustering)在没有给定类别标签时,依据数据特征和相似性寻找分组。可用于整理邮件、搜索结果或探索异常结构;“簇”是否对应真实语义类别,需要结合任务检查。
下面的分配—均值更新流程是 K-means,不是所有聚类算法的通用流程。
目标函数
给定簇数 \(K\),为每个样本选择簇 \(z_i\in\{1,\ldots,K\}\) 和中心 \(\boldsymbol\mu_1,\ldots,\boldsymbol\mu_K\),最小化簇内平方误差:
\[ J=\sum_{i=1}^N\|\mathbf{x}_i-\boldsymbol\mu_{z_i}\|_2^2. \]
这里是平方欧几里得距离之和,不是普通距离之和。普通距离和对应的最优中心通常不是算术均值。
Lloyd 迭代
- 初始化 \(K\) 个中心,例如随机选取不同数据点,或使用 K-means++。
- 分配(assignment):固定中心,把每个点分配给最近的中心。
- 更新(update):固定分配,把每个非空簇中心改成该簇样本均值。
- 重复,直到分配不变、中心变化足够小或达到最大迭代次数。
\[ z_i\in\arg\min_k\|\mathbf{x}_i-\boldsymbol\mu_k\|_2^2, \qquad \boldsymbol\mu_k=\frac{1}{N_k}\sum_{i:z_i=k}\mathbf{x}_i. \]
若有空簇,\(N_k=0\) 时上式无定义,必须指定重新选中心、重新分配点等处理方式。每次迭代的常见时间量级为 \(O(NKD)\),其中 \(D\) 是特征维数。
随机性与收敛
随机性通常来自初始化。固定初始中心、数据顺序和距离相等时的平局规则后,标准 Lloyd 迭代可以是确定性的。
在非空簇等标准条件下,分配与均值更新都使 \(J\) 不增加,可能保持不变,并非每次都严格减小。有限数据、适当固定的平局处理下,标准流程会达到稳定划分;浮点实现通常以容差和迭代上限停止。它不保证全局最优,且受初始化影响,常采用多次初始化并选取最低目标值结果。
适用性与局限
- 欧几里得距离受特征尺度影响,应根据含义决定是否标准化。
- 对较紧凑、近似球状、尺度相近的簇通常较适合;非凸形状、密度差异大或离群点多时可能表现不佳。
- \(K\) 需要选择;目标值随 \(K\) 增大通常下降,不能只靠训练目标越小就认定分组越合理。
- 清晰的几何分组也不保证自动找到“真实模式”,更不保证具有任务语义;应结合稳定性、内部指标或可用外部信息评价。
初始化与三个常见问题
若随机选到的中心都集中在数据一侧,可能产生差的稳定划分,或出现没有样本分配给某个中心的空簇。随机种子、初始化方法和空簇处理因此都会影响实际结果。
- Will K-means converge? 标准分配与均值更新使平方误差目标不增加,在适当平局与空簇处理条件下达到稳定划分;不保证全局最优。
- Will it find the true patterns? 若数据接近球状、簇间距离明显且尺度相近,可能得到合适结果;任务中的真实类别不一定符合这个几何假设。
- Will it find something interesting? 邮件、搜索结果或程序执行记录的分组可以辅助分析,但目标只度量几何误差,结果是否有意义仍需结合业务或语义解释。